6. Funcionamiento del coordinador
En esta sección
Estado del coordinador
Conviene abrir el coordinador y examinar qué guarda dentro, porque de aquí en adelante vamos a ocuparnos de lo que sucede cuando las cosas fallan: un chunkserver, servicios enteros, el propio coordinador. De qué puede recuperarse y de qué no depende enteramente de qué información maneja.
La primera decisión es sobre las estructuras de datos, y está tomada pensando en la velocidad: el coordinador tiene prácticamente todas sus estructuras en memoria, seguramente muchas hash tables. De ahí salen las respuestas que les da a los clientes. Y además tiene una parte persistente: un log, en el sentido de base de datos, al que de vez en cuando se le sacan snapshots.
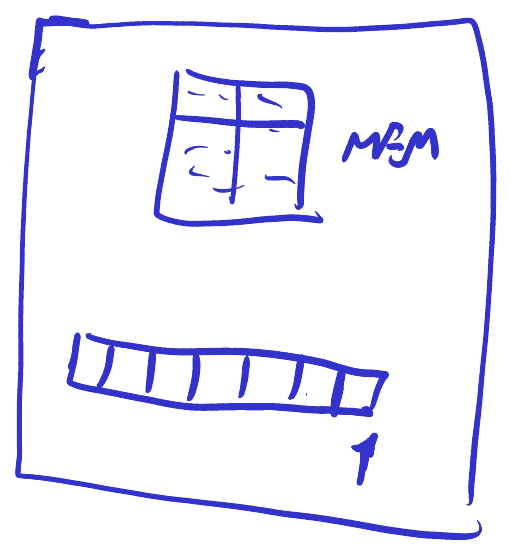
En ese log se guarda cada operación que le llega: cada archivo nuevo, cada chunk nuevo, cada cambio. Y no sirve únicamente para el propio coordinador: también para enviárselo a un backup, del que nos vamos a ocupar enseguida.
La idea de fondo es que, si el coordinador falla y tiene que reiniciarse, no toda la información que tenía en memoria le va a hacer falta: parte la puede reconstruir, otra parte necesariamente tiene que ser persistente. Distinguirlas es el ejercicio interesante, porque no es lo mismo perder algo que se puede volver a averiguar preguntando que perder algo que no está en ningún otro lado.
Lo necesariamente persistente es el mapeo entre los file names y los chunks. Si se pierde eso, se pierde todo, y es además lo único que no se puede reconstruir preguntándole a nadie. Esa es la información que vive en el log: cada tanto se crea un snapshot de la memoria, y cuando la máquina vuelve a iniciarse se carga ese snapshot y se vuelven a aplicar —igual que en una base de datos— las últimas entradas del log.
Lo que no es tan obvio, y también es una decisión de diseño, es el otro mapeo: el que dice en qué máquinas está cada chunk. Ese no se guarda en disco, y lo interesante está en lo que supone esa decisión: que la autoridad sobre qué contiene cada máquina son los propios chunkservers. Cuando el coordinador se reinicia, les consulta a todos qué chunk handles alojan y reconstruye la lista en el momento. No la persiste: la vuelve a armar cada vez.
La última pieza es un número de versión por chunk. Se incrementa cada vez que el coordinador elige un nuevo primary dentro de ese grupo, y sirve para detectar una situación concreta: la del chunkserver que falló y volvió a levantarse dos días después. Cuando reaparece trae un número muy anterior, y con eso alcanza para saber que quedó desactualizado. Lo usan las otras réplicas, el coordinador y los clientes.
Leases y split brain
¿Y cómo elige el coordinador a ese primary? Es la última pieza importante, y con ella pagamos una promesa hecha al presentar las escrituras: tenía que haber un primary y no más de uno, porque si hubiera dos caeríamos en el split brain.
El mecanismo es un sistema de leases, basado en tiempo. Un lease es un permiso para actuar de primary. En algunas traducciones se lo denomina arrendamiento, y la imagen es adecuada, porque el coordinador otorga ese permiso por un tiempo acotado: 60 segundos, un valor fijado por convención. La réplica que recibe el lease se compromete a dejar de ser primary cuando se vence, y también lo puede renovar si todo sigue en orden.
Empecemos por el caso normal: el coordinador y tres chunkservers, uno primary y dos secondaries, los tres enviándole heartbeats. Si el primary falla, queremos que el coordinador determine que ya no lo es y promueva a uno de los dos secondaries.
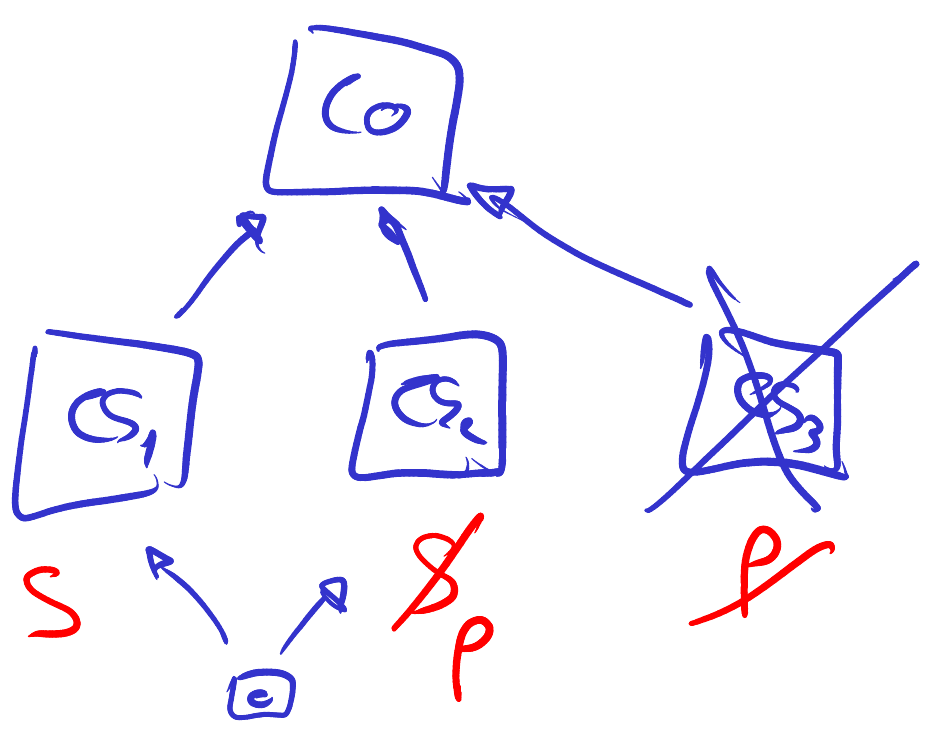
La pregunta es por qué no se puede hacer eso directamente, sin esperar nada. Y la respuesta es que hay otra situación, casi idéntica vista desde el coordinador, en la que hacerlo de inmediato resulta muy problemático.
Volvamos a la misma escena, pero ahora no falla la máquina sino la conexión de red. Empieza a verse un patrón: no son solamente las máquinas las que fallan, también las conexiones. Y desde la primera clase venimos insistiendo en que para el coordinador resulta indistinguible que haya fallado el primary, un router o la red.
Lo que puede ocurrir es que se interrumpa esa única conexión y que del otro lado la actividad continúe: clientes que siguen comunicándose con ese primary sin inconvenientes, y un primary que quizá siga teniendo conexión con las demás réplicas. Si el coordinador se precipita y designa a uno de los secondaries como nuevo primary, el resultado es una situación confusa. Una máquina que sigue pensando que es el primary, porque con la conexión cortada el coordinador nunca le pudo decir lo contrario. Clientes que, con la información cacheada, la siguen tratando como primary. Y clientes nuevos que consultaron al coordinador y se dirigen al otro. En parte porque la falla de red no es uniforme y en parte por el cacheo, terminamos con dos primaries. Eso es el split brain, y es justamente lo que no queremos.
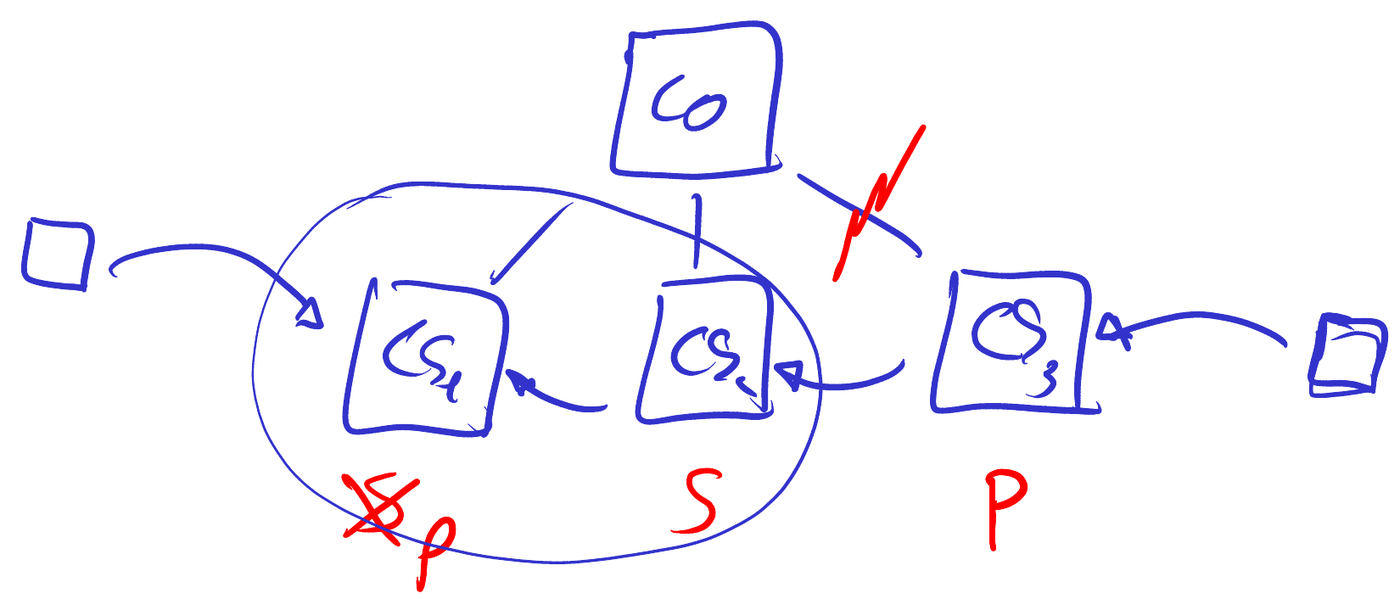
Lo grave no es solamente que las copias evolucionen en paralelo: es peor, se vuelve un desorden generalizado. Los dos primaries van a enviar escrituras compitiendo entre sí, van a generar muchísimas regiones inconsistentes, les van a responder errores a los clientes de cada lado, y los clientes, que frente a un error tienen que reintentar, van a seguir reintentando, con lo cual quedan todavía más regiones inconsistentes.
La forma de evitarlo es simple y básica. Si el coordinador, en vez de apurarse, espera que pase un minuto, hay algo que sabe con certeza: que el primary original, al pasar ese minuto sin poder renovar el lease, automáticamente dejó de ser primary y de aceptar escrituras. Se comprometió a eso al tomarlo, y el compromiso no depende de que nadie se lo notifique. Ahí está lo elegante: sin intercambiar un solo mensaje con el primary anterior, solamente esperando, el coordinador puede designar con seguridad un nuevo primary en otro lugar.
Quizá esa parte de la red siga interrumpida, pero del lado favorable del corte se conforma una subred con dos máquinas y un primary, mientras el resto queda sin avanzar. Cuando la conexión se restablezca habrá que ver cómo se reconcilian las cosas, pero mientras tanto los datos no divergen. El cliente que quedó del lado cortado va a recibir un error de otro tipo, que le dice que ese servidor está desconectado y que no reintente. Esa es la función principal de los leases.
A eso se le suman los números de versión. Cada vez que se elige o se renueva un primary el número se incrementa, y los clientes lo pueden usar para saber si están comunicándose con una máquina desactualizada: reciben del coordinador la lista de máquinas y el número actual, y si después una responde con un número anterior, la ignoran. El mismo número coordina a las máquinas entre sí: si una se conecta con un número anterior, el coordinador le indica que quedó desactualizada y que debe sincronizarse con el resto antes de poder reincorporarse al grupo de replicación.
Esta es la parte más confusa del paper: cómo funcionan exactamente los números de versión y los errores no está del todo aclarado. Pero la esencia se resume en una frase: el lease es un mecanismo contra el split brain, y todo lo que tiene que hacer el coordinador, si deja de poder comunicarse con el primary actual, es esperar un minuto y después asignarle el rol a otra máquina con total seguridad.