2. Abstracción y arquitectura
En esta sección
Abstracciones fundamentales
La abstracción fundamental del sistema es el archivo: tiene un nombre y una enorme cantidad de datos, y se lo ubica dentro de un sistema de directorios que sirve para nombrar los objetos, algo como /dir/file.txt. Hasta ahí ninguna sorpresa. La particularidad, además de ser muy grande, es que se lo divide en fragmentos.
A esos fragmentos les llaman, literalmente, pedazos: en inglés, chunks. Tienen un tamaño fijo, que en Google eligieron después de evaluar cuál sería razonable: 64 megabytes. Para los estándares actuales resulta pequeño, pero a principios de los 2000 era un archivo de gran tamaño.
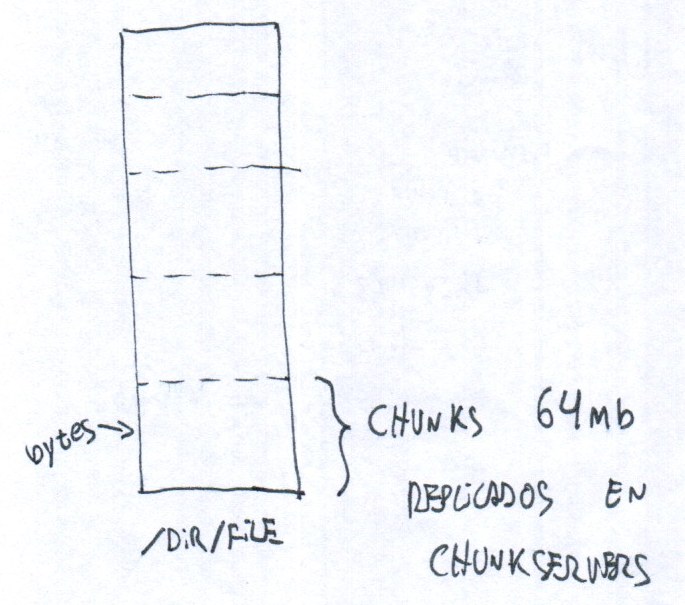
Y esos chunks van a estar copiados en varios lugares. Un chunk es, en definitiva, una implementación concreta de sharding, o particionado. Ese nombre merece atención, porque vamos a insistir en bautizar con un término general a ciertos patrones que se repiten: cada sistema le pone una etiqueta diferente, y ninguno funciona exactamente como lo explicamos en teoría, pero la idea es identificarlos cuando aparecen disfrazados. Ese es el ejercicio frente a cada sistema nuevo: reconocer, detrás del nombre propio que le pusieron sus autores, el patrón general que aplica por debajo. Y partir un archivo en fragmentos se hace, en el fondo, para poder repartirlo entre muchas máquinas.
Dentro de esas máquinas cada chunk termina siendo un archivo común de Linux. Todo esto funciona sobre Linux común y corriente y encima toma una capa de abstracción —un middleware, si se quiere, aunque el término resulte confuso— que hace que todos esos pedazos dispersos sean un único archivo lógico. Estos son los archivos que van a servir de input y de output de MapReduce, que trabaja con ellos como si fueran archivos y nada más; pero a la larga cada chunk termina siendo un archivo de Linux en algún disco de alguna máquina del sistema.
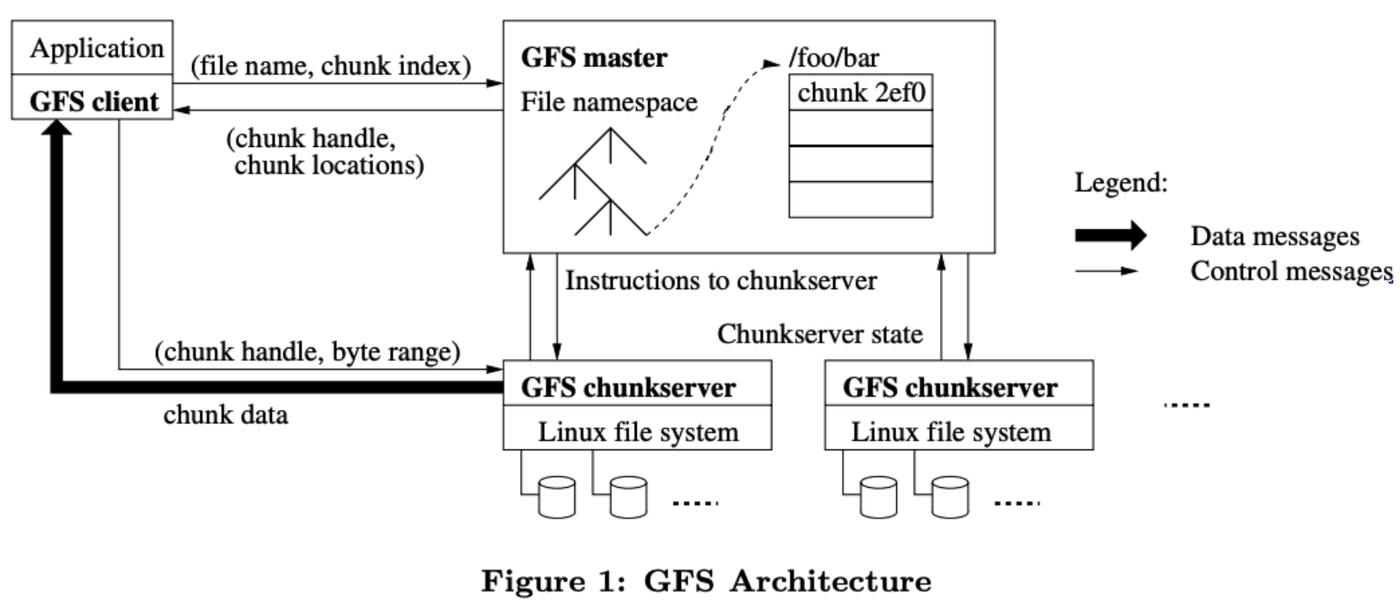
Vamos a la arquitectura. El GFS tiene tres clases de componentes, y en conjunto se parecen a la estructura que ya conocemos de MapReduce.
El primero es el Google File System master, al que también vamos a llamar coordinador. Es una única máquina —más adelante vamos a ver cómo se evita que su falla arrastre a todo el sistema— y es la que tiene la estructura del file system, el árbol de nombres, y la que dice dónde está cada cosa. Cuando sigamos cómo se ejecuta un read va a quedar más claro qué tiene adentro.
Los segundos, y son los importantes, son los chunkservers: una máquina común, con Linux y discos rígidos, que ejecuta un proceso servidor para interactuar tanto con el master como con las aplicaciones. Ahí están los datos reales, y de ahí vamos a leer y escribir.
El tercero es el cliente. La idea era que cada aplicación tuviera lo que se suele llamar un cliente, aunque este se parece más a un middleware.
No es tan pequeño como la biblioteca que uno usa para hacer RPC: no es un gRPC, tiene lógica en un sentido fuerte, no es un pasamanos de la aplicación. Tenía que tomar decisiones y hacer cálculos.
La primera de esas cuentas aparece enseguida. Cuando queremos leer o escribir sobre un archivo partido en muchos chunks, lo primero que el cliente tiene que calcular es a cuál de esos chunks corresponde la posición pedida. La aplicación le pasa el file name y el offset; pero cuando el cliente se comunica con el master, le envía el file name y directamente el chunk index. La traducción es una simple división: el offset es una medida en bytes, y dividido por el tamaño de chunk, esos 64 megabytes, queda el índice —0, 1, 2, 3, el que corresponda—. Ahí ya hay lógica escondida adentro del cliente.
Que un cliente cargue con esa clase de lógica no es una decisión inocente, y funcionaba porque era Google: internamente se daba por supuesto que sus desarrolladores sabían usar bien estas herramientas, y por eso podían permitirse entregarles un cliente complejo. Más que un cliente, era una biblioteca para acceder a todos estos sistemas.
Flujo de lectura
Sigamos una lectura de extremo a extremo, que es la forma más sencilla de entenderla. El cliente llama a read con el file name, el offset y quizás un buffer, según cómo esté implementada la biblioteca; con eso calcula el chunk index. Y lo primero que hace es preguntarle al coordinador dónde están los servidores concretos que tienen ese chunk. En el dibujo hay dos chunkservers, pero la escala real son cientos o miles de máquinas, cada una con muchos chunks de muchos archivos distintos.
El cliente le pide el file name y el chunk index; el master devuelve dos cosas, un chunk handle y las chunk locations. El chunk handle es un número que identifica universalmente al chunk: el paper especifica un entero de 64 bits, un int64, y esa unicidad global simplifica el diseño, porque evita que dos chunks se superpongan.
Lo otro que devuelve es la ubicación de todos los servidores que tienen una copia. En el dibujo hay dos; el paper dice que típicamente usaban tres. No hay ninguna restricción: podrían ser dos, tres o cuatro, y el número no tiene que ser par ni impar. Tres resultaba razonable, porque así, si fallaba una máquina, no quedaban al borde de tener una sola réplica.
El cliente cachea esos datos en memoria por dos razones: para no estar interactuando con el master constantemente, y para descargarlo, porque es una única máquina a la que todos los clientes le consultan ubicaciones permanentemente. Cada ubicación cacheada es una pregunta que el master no recibe.
Sabiendo dónde están las réplicas, el cliente va directo al chunkserver que el paper llama el más cercano. Cómo se calcula esa cercanía es más rudimentario de lo que uno esperaría: la topología de la red es lo bastante simple como para estimar las distancias con precisión a partir de las direcciones IP. El más cercano puede estar en el mismo data center, en el mismo rack, o incluso correr en la misma máquina, porque ejecutaban varios servicios diferentes dentro de un mismo host: podía haber un mapper de MapReduce y un chunkserver conviviendo, y podía ocurrir que ese chunkserver tuviera precisamente los archivos que necesitamos. En ese caso la llamada es local y es mucho más rápida; vamos a ver más adelante que eso lo hacen a propósito. Elegida la réplica, el cliente le envía el byte range que quiere leer y el chunkserver le devuelve los datos.
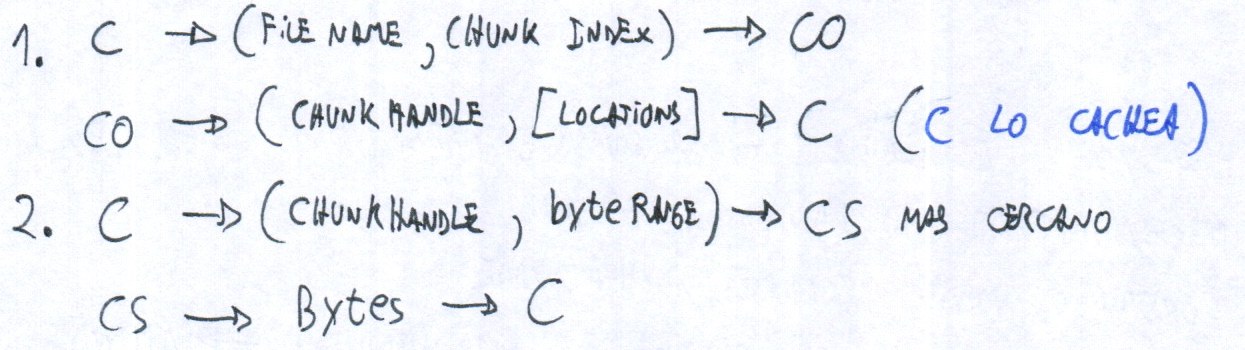
Dos cosas son interesantes. El coordinador solo tiene metadata. Y los datos no pasan por él: no es un punto centralizado por donde pasen todos los datos. El cliente hace dos llamadas a dos sistemas diferentes, a menos que ya tenga la ubicación cacheada, y eso es para aliviar al master, para que no sea el router central de todos los datos.