4. Garantías de consistencia
Escrituras no atómicas y append
Ese error merece que nos detengamos, porque es aquí donde el GFS muestra su costado más delicado: los requisitos de consistencia son sumamente relajados. Relajados quiere decir, ante todo, que el sistema no implementa lo que sería un atomic write: justamente la propiedad que uno esperaría de un sistema de storage.
¿Y por qué no la ofrece? Por lo que ya vimos del flujo de escritura. El primary aplica la mutación localmente primero y solo después se la envía a las demás réplicas. Puede pasar perfectamente que se aplique en el primary y en una de las réplicas, y no llegue a la tercera porque falló, porque la red está interrumpida o por cualquier otra razón. Quedan dos réplicas con un contenido y la tercera con otro. Y para el GFS eso es admisible: es un estado aceptable, no una anomalía que haya que reparar.
Se cobra aquí el anticipo que dejamos al abrir las escrituras: las réplicas de un chunk no son necesariamente iguales, y aquel supuesto de tres copias idénticas era una simplificación transitoria. Es un requisito incómodo para quien implementa aplicaciones sobre el sistema, porque lo obliga a aplicar técnicas propias para contemplar esos casos.
¿Qué se espera que pase cuando ocurre un error y quedamos inconsistentes? Que el cliente reintente. Pero el reintento tampoco es gratis.
Lo que explica el paper es que el primary, si le manda la mutación a un secondary y falla, va a reintentar un par de veces —puede haber quedado fuera de servicio temporalmente y volver un instante después—, pero eventualmente desiste y le devuelve error al cliente. Ese es un error parcial: parte del trabajo quedó hecho y parte no, y tampoco está claro cuán explícito llega a ser el mensaje.
El sistema tiene dos tipos de escritura, y el interesante es el segundo. Uno es el write común, del que casi no se habla en el paper: recibe el archivo, los datos y el offset donde hay que escribirlos. El otro es el append, el importante y el que usa muchísimo MapReduce: recibe el archivo y los datos, y nada más, porque agrega al final del archivo. Y este sí devuelve algo: el offset donde terminó de escribir.
La implementación es razonable. La diferencia importante entre el write común y el append —además de que el append es más atómico, por unas razones que el paper no termina de aclarar— es quién decide el offset. En el append lo decide el primary, no lo envía el cliente: al escribir, además de asignarle un número de secuencia a la operación, le asigna el offset donde va a terminar escribiéndose.
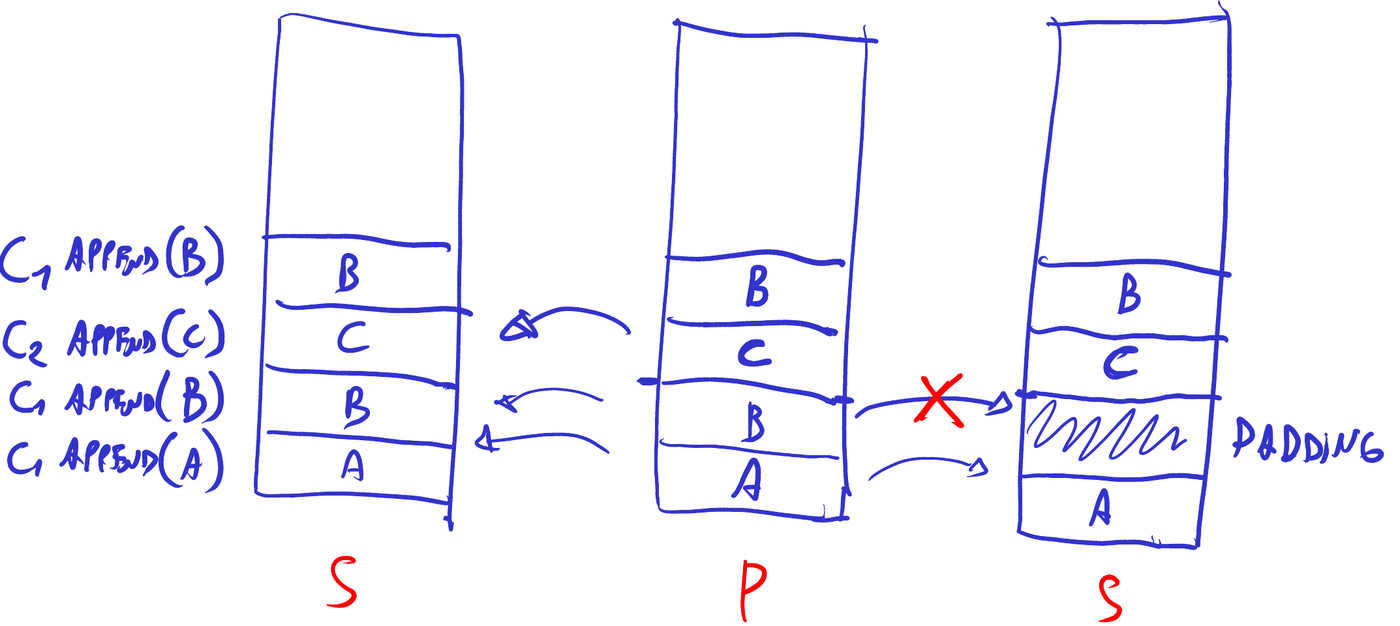
Veámoslo con un ejemplo. Tenemos un archivo y sus tres réplicas en tres servidores: la del centro es el primary, las laterales los secondaries. Empecemos por el caso feliz. El cliente 1 hace append(A), donde A es un registro de cualquier tipo: primero se aplica en el primary, y después el primary les indica a las otras dos réplicas que apliquen A, enviándoles también el offset. Una lo aplica y la otra también.
Después el cliente 1, o el 2, o cualquier otro, hace un nuevo append de un registro diferente, B. Como siempre, entra por el primary, que se lo envía a un secondary y funciona, y al otro y no funciona. Hace retry, insiste, pero eventualmente falla por completo e informa al cliente que la operación no se completó. En este punto dos réplicas tienen B y la tercera no.
Y aquí es donde la situación se vuelve interesante, porque concurrentemente hay otro cliente que quiere escribir el registro C. Ese append también entra por el primary, que elige ubicarlo al final del archivo —a continuación de B— y les envía a las dos réplicas laterales la orden de escribir C en ese offset. La tercera, la que se había perdido B, escribe C exactamente en ese offset: C queda alineado con las otras dos copias y en el lugar donde debería haber estado B queda un hueco. A ese hueco se lo suele llamar padding: pueden ser ceros o cualquier otro carácter. Es un espacio vacío en el archivo, y esa región es la que el paper llama inconsistente: quiere decir precisamente esto, que las tres réplicas pueden tener información diferente.
Eso se produce cuando el sistema nos devuelve un error: puede haber otros, pero este en particular nos dice que la región quedó inconsistente y que lo único que le queda al cliente es un retry.
El cliente 1, por último, reintenta su append de B. Y aparece otra de las relajaciones de consistencia, tan importante como la anterior: no importa que B ya se haya escrito antes, porque el sistema no tiene ninguna deduplicación de registros. Lo va a escribir de nuevo en las tres. Además, mientras se hacía el retry pueden haberse intercalado otras escrituras, como acaba de ocurrir con C. Supongamos que ahora sí funciona.
El resultado es incómodo. Las dos primeras réplicas quedaron iguales entre sí, con A, B, C y B: el registro B duplicado. La tercera quedó con A, un hueco de padding, C y B. Ninguna de las tres es una copia fiel de las otras dos.
Manejo de inconsistencias en el cliente
La pregunta que queda abierta es qué hacer en un caso así, y sobre todo quién resuelve el problema. La respuesta es otra decisión de diseño importante y nada obvia: lo resuelve el cliente. Quien usa el sistema es el que debe hacerse cargo de los duplicados y de los huecos. El problema se traslada a la capa superior.
Hay dos técnicas interesantes con las que puede encararlo. La primera resuelve los duplicados que produjo el reintento, esos dos B que quedaron uno encima del otro, y hay que resolverlos en la lectura: quien consume estos archivos necesita alguna forma de evitar procesar dos veces lo mismo. La manera estándar es con identificadores únicos: se guarda en memoria una estructura con los registros ya procesados —un set, un hash set— y si llega uno repetido, se lo ignora.
La segunda resuelve las regiones con padding. Hace falta detectar que lo que hay ahí no es un registro válido, y para eso se puede usar un checksum: un dígito verificador —sumar todo y exigir que dé cierto valor, o cualquier variante equivalente— que permita comprobar si lo que leemos son datos inválidos o un registro legítimo. Detectar el padding es sencillo incluso sin eso, porque simplemente no cumple con el formato; pero la recomendación del paper es que los registros lleven un checksum verificable, la misma idea que se aplica al validar una descarga.
Ninguna de las dos técnicas es específica de los sistemas distribuidos —son recursos que ya se conocen de otras materias—, pero aquí hay que aplicarlas: el sistema no tiene commits atómicos y la consistencia que ofrece es bastante pobre.
Con un write atómico nada de esto hubiera ocurrido. Cuando la escritura de B falló en una réplica, tendría que haberse deshecho todo: que B no quedara escrito ni en el primary ni en la réplica donde sí había llegado. Que cuando algo falla, no quede rastro. Así se resuelven de inmediato los duplicados y el padding, porque el intento fallido no dejaría ninguna huella.
Visto así parece imposible, pero es exactamente lo que vamos a ver que resuelve Raft, que tiene writes atómicos y ataca justamente este tipo de problemas.