2. Sistemas distribuidos: definición y motivaciones
En esta sección
Multiprocesador frente a sistema distribuido
Con todo ese preámbulo ya estamos en condiciones de definir qué entendemos por un sistema distribuido. Conviene dar esa definición al revés, empezando por decir qué no es, porque configuraciones posibles hay varias y no todas cuentan.
No es un sistema donde hay una memoria —memoria propiamente dicha, memoria RAM— y varios CPUs conectados a ella. Ahí estamos muy bien a bajo nivel, pero cuando tenemos varios CPUs conectados a la misma memoria, como ocurre en cualquier máquina multicore —que es como son todas las máquinas hoy—, eso es un multiprocesador y no un sistema distribuido.
Un sistema distribuido va a ser otra cosa: una memoria y otra memoria, un CPU y otro CPU, cada CPU con la suya. Lo que cambia es la conexión entre los dos, que ahora pasa a ser un enlace, una red. El dibujo es esquemático y a alguien de organización de computadoras podría no gustarle, porque los CPUs no se conectan literalmente de esa manera; pero ese enlace está ahí para enfatizar una sola cosa, la importante: este CPU no puede acceder directamente a aquella memoria.
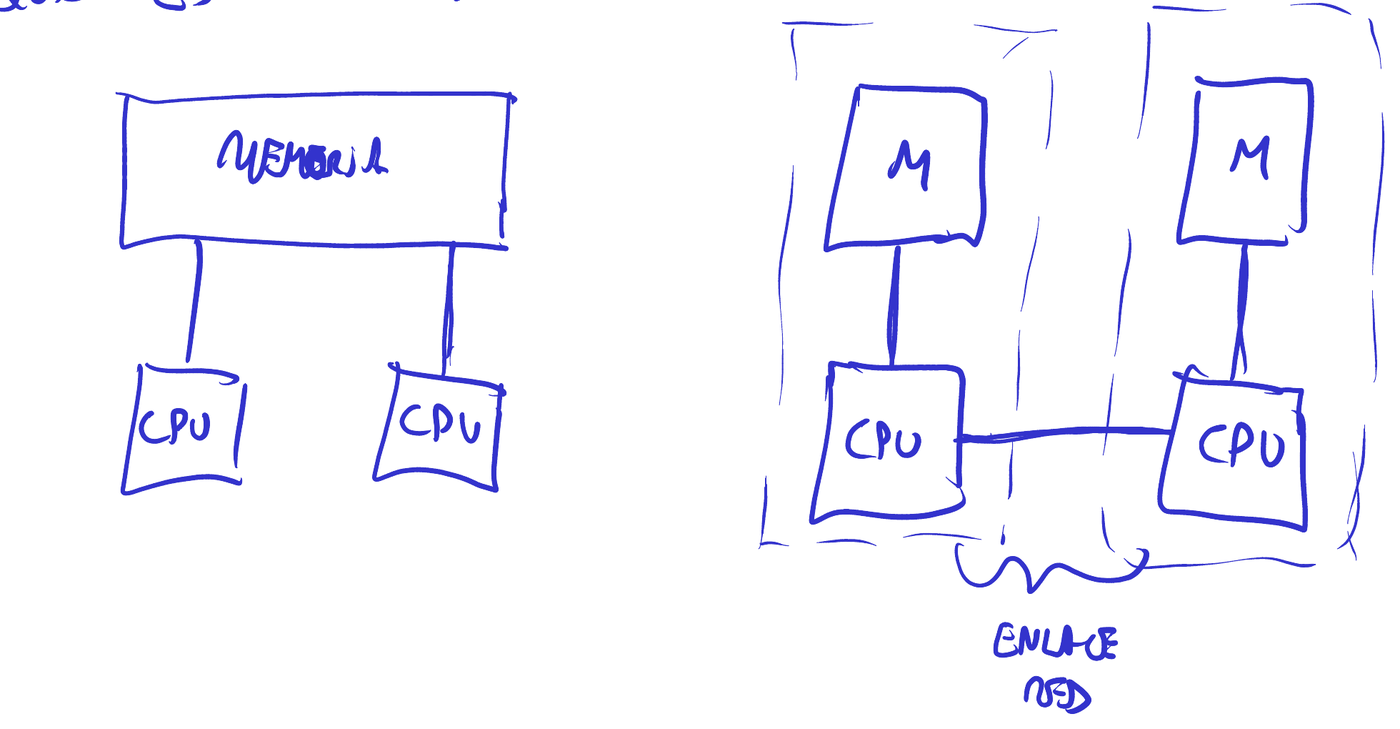
Y eso nos complica el panorama. Muchas de las cosas que ya sabemos hacer dejan de valer. Cuando programamos con procesos, si bien están aislados entre sí, sabemos que podemos recurrir a memoria compartida o a otros mecanismos para que dos procesos escriban sobre la misma memoria. Cuando programamos con threads, más todavía. Aquí eso es físicamente imposible: son dos máquinas separadas y no hay forma de que una escriba en la memoria de la otra.
A lo sumo podemos armar un sistema que simule una memoria compartida, y va a ser eso, una simulación: el CPU siempre va a tener que pasar por el otro CPU para poder escribir en esa memoria. No tenemos un bus PCI que atraviese el data center y conecte dos memorias entre sí.
Esos son los sistemas que vamos a armar nosotros. La separación puede ser una ventaja en algunas ocasiones y una desventaja en otras, y lo que sigue es justamente ver cuáles son las ventajas.
Escalabilidad y tolerancia a fallas
¿Por qué querríamos complicarnos así? Empecemos por las razones más habituales.
La primera es la escalabilidad. Lo que queremos es un sistema que se pueda hacer más grande, y hay dos maneras de darle más potencia: más capacidad de procesar datos, más capacidad de storage, lo que haga falta.
La más típica es el escalamiento vertical, que consiste en comprar una máquina más grande. Si el procesador resulta lento, compramos uno más grande; si se nos está acabando el disco, agregamos uno más grande. Es poner una máquina más potente en lugar de la pequeña para hacer exactamente lo mismo.
La otra se llama escalamiento horizontal, y es donde los sistemas distribuidos tienen verdadero sentido: en lugar de una máquina más grande, ponemos más máquinas, que trabajan en paralelo.
Hay una advertencia que hacer de inmediato. Tomar un sistema que funciona con una máquina y agregarle más máquinas, si no lo pensamos bien, no va a funcionar: el sistema tiene que estar diseñado para poder escalarse horizontalmente. Cómo hacer un sistema que pueda escalar horizontalmente es, en esencia, el contenido de la materia.
La otra razón es la tolerancia a fallas. Cuando tenemos una única máquina, si bien se pueden aislar un poco las fallas entre sí, generalmente cuando una máquina muere, muere entera. Los sistemas operativos tratan de aislar las fallas entre procesos, pero siempre hay cosas que pueden afectar a la máquina entera. Cuando las máquinas están separadas físicamente, en cambio, pueden fallar de manera independiente. Y si usamos algunas técnicas de redundancia podemos tolerar que mueran máquinas enteras y que el sistema, como un todo, siga funcionando. Los nodos pueden morir; el sistema sigue, en lo que se suele llamar una falla parcial.
Hay otras razones que se iran elaborando y mas especializadas, y que muchas veces son una consecuencia de las primeras dos. Una es compartir recursos: si el recurso está físicamente en otro lugar, podemos usar un sistema distribuido para acceder a él. Otra es la distribución geográfica.
Economía de escala y commodity hardware
Otra de esas razones por las que se construyen sistemas distribuidas es de índole economica; en particular, la economía de escala. Estos sistemas, cuando escalan horizontalmente, tienden a salir más baratos que comprar una máquina más grande. La potencia que se consigue es muchísimo mayor, y sobre todo el costo por unidad de potencia es muchísimo mejor escalando horizontalmente que comprando máquinas cada vez más grandes.
De esto tomaron nota en Google, que fue quien uno de los primeros en difundir los clústeres de computadoras baratas: lo que se conoce como commodity hardware. Commodity se refiere a hardware no especializado ampliamentente disponible en el mercado y por lo tanto con precios bajos y más o menos estandarizados. No usaron servidores especiales ni equipamiento fuera de lo común: eran máquinas que compraron, atornillaron entre sí, y con eso armaron una supercomputadora improvisada.
Lo que querían resolver es lo que vamos a ver la clase que viene. Querían indexar la web entera: escanearla, recorrerla con un crawler, armar un índice invertido. Era un problema computacionalmente gigantesco. Por eso inventaron MapReduce, que corría en muchísimos nodos. ¿Y qué eran esos nodos? Máquinas modestas y baratas, que se rompían con frecuencia y cuya falla no generaba mayor preocupación: se descartaba la que se había roto y se colocaba otra en su lugar. Si necesitaban más potencia, compraban más máquinas y las agregaban al clúster, y el sistema estaba diseñado para escalar sin inconvenientes.
Se suele señalar a Google como uno de los pioneros en usar commodity hardware para resolver problemas reales, y en efecto todo empezó como un proyecto de investigación en Stanford. Lo que Google no inventó es el término cluster computing: juntar máquinas para que trabajen como una sola es una idea bastante anterior a la empresa. Lo que sí hizo fue llevarla a una escala que nadie había intentado, y con las máquinas más baratas que había a mano.
El primer producto comercial de clustering fue el Attached Resource Computer de Datapoint, de 1977, y la práctica se difundió con el VAXcluster que Digital Equipment lanzó en 1984 para VMS. El antecedente más cercano al modelo de Google son los clústeres Beowulf, que Thomas Sterling y Donald Becker armaron en la NASA en 1994 con PCs de venta masiva. Google se fundó en 1998.
Hay un caso célebre de esa misma idea. En 2010, la Fuerza Aérea de los Estados Unidos compró unas mil setecientas PlayStation 3 para armar una supercomputadora, y ahí la economía de escala se ve con una nitidez que ningún argumento abstracto consigue: el equipamiento equivalente en máquinas de propósito específico costaba unos diez mil dólares por unidad, así que las mil setecientas habrían salido diecisiete millones de dólares. El clúster de consolas costó dos, y encima consumía la décima parte de la energía.
El Condor Cluster del Air Force Research Laboratory, inaugurado el 1 de diciembre de 2010 en Rome, Nueva York, con 1.760 consolas.
Algo parecido ocurre hoy con las GPUs. Todos los entrenamientos de redes neuronales se están haciendo con clústeres de máquinas que tienen muchísimas GPUs. Y ahí aparece una sutileza que conecta con la distinción del principio: las GPUs que entrenan redes neuronales se parecen más al modelo de memoria compartida, porque hay distintas clases de memoria pero es una máquina donde la GPU tiene acceso directo a la memoria. Lo que hacen las empresas es combinar esas máquinas entre sí para poder entrenar entre muchas y escalar el entrenamiento. Y ahí terminan combinándose las dos cosas a la vez: la multiprogramación con el sistema distribuido.
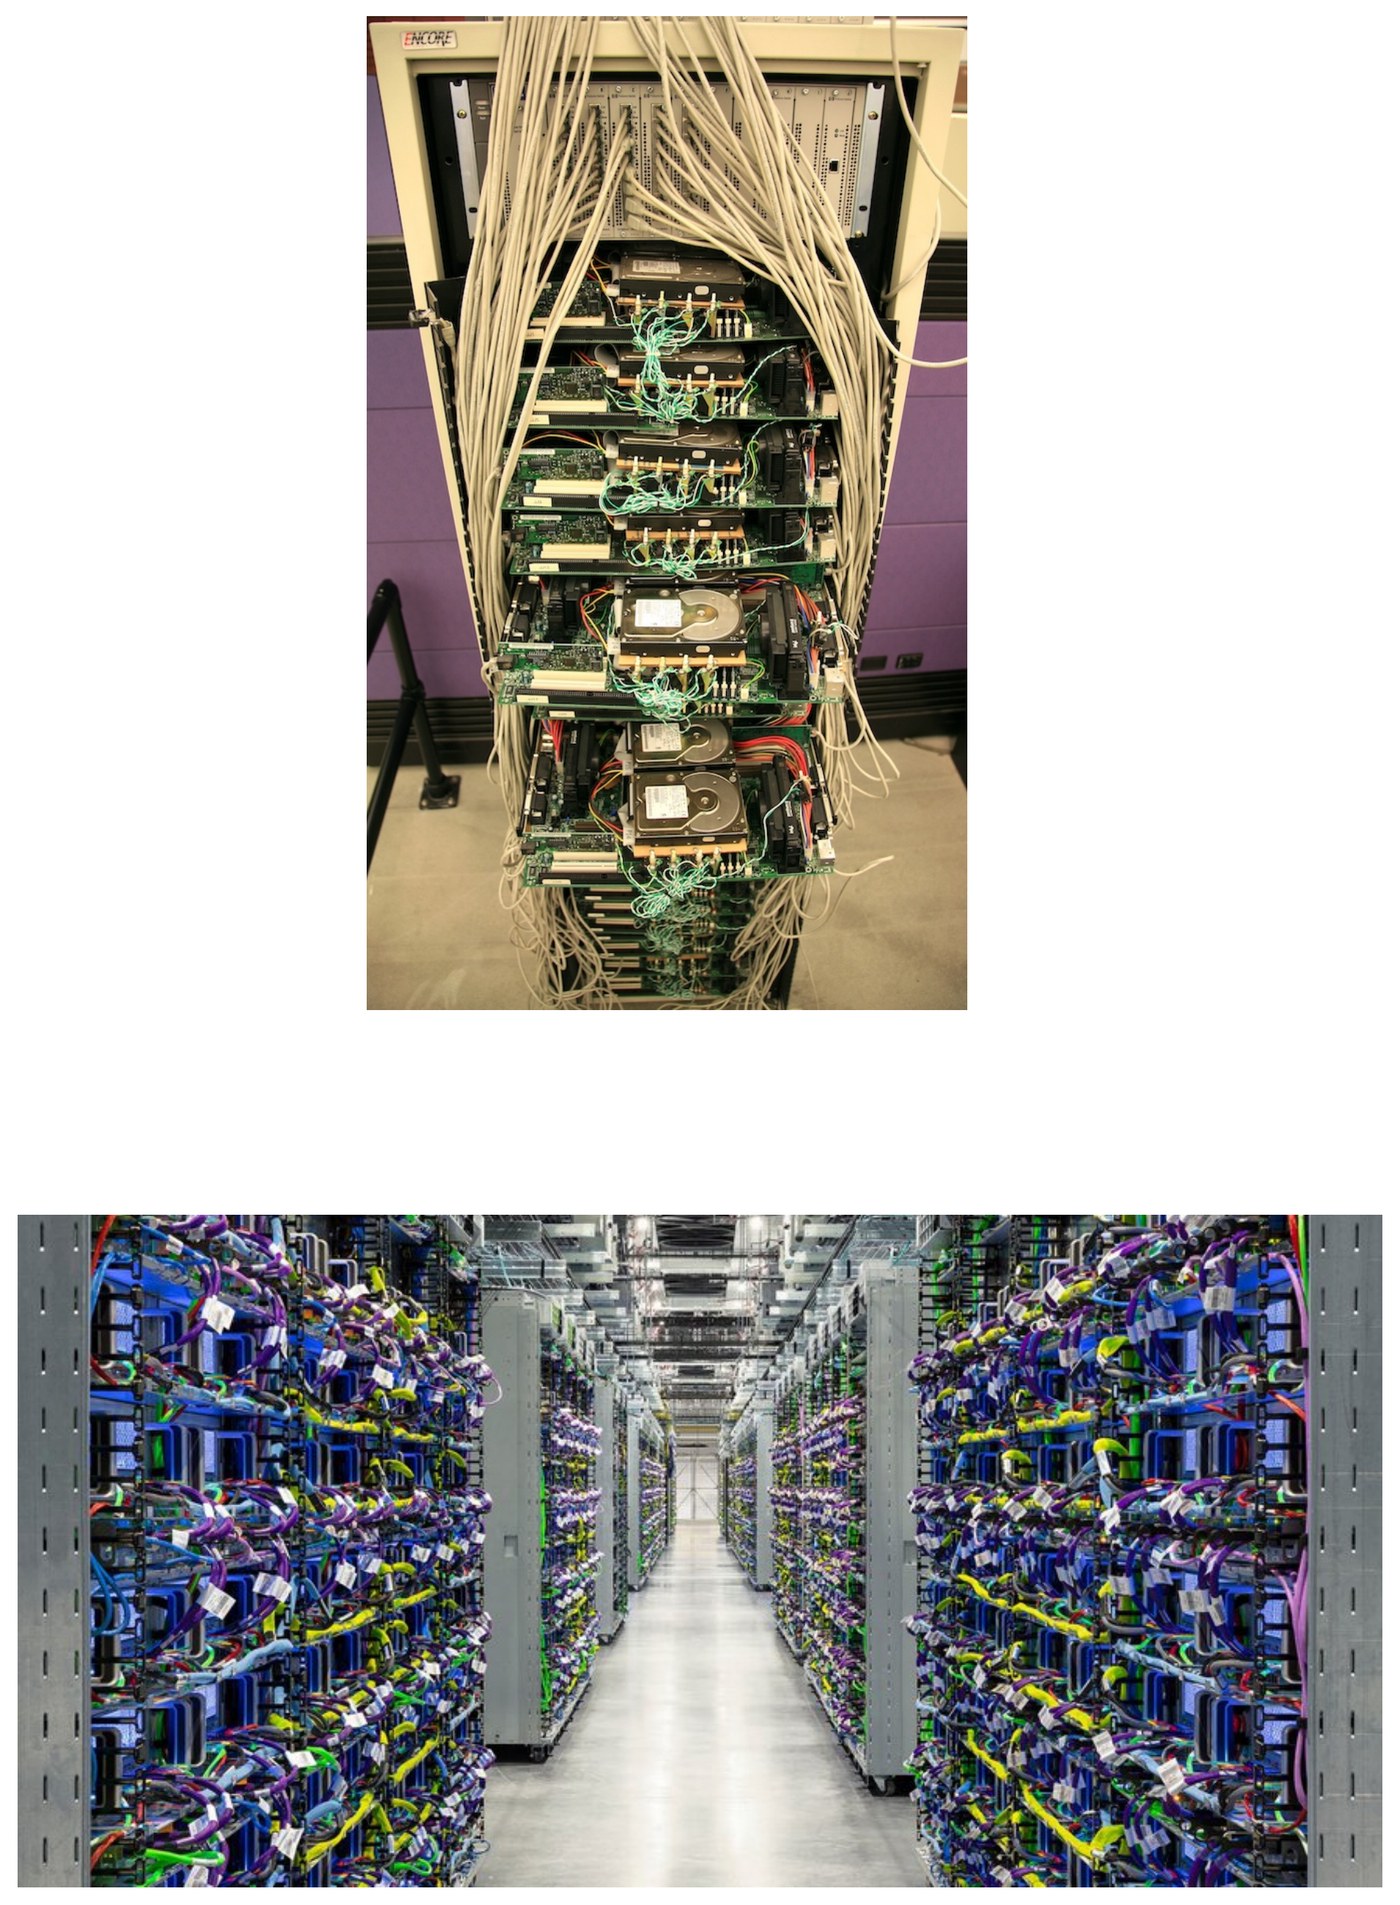
De hecho, el cluster computing en este sentido —tomar muchas máquinas comunes y hacer data centers gigantes con muchísimas veces la misma máquina— es lo que permitió el Cloud. La historia que se suele contar es que el problema de Amazon era que había armado uno de estos data centers para tener la capacidad que necesitaban en Navidad, y que después empezaron a alquilarle a la gente esa capacidad de cómputo que les quedaba ociosa el resto del año. Es una historia si bien es pintorezca fue desmentida por los propios ejecutivos de Amazon más de una vez. Lo que efectivamente ocurrió es menos cinematográfico y más interesante, porque el servicio se diseñó desde el principio para venderse como un servicio a consumidores finales. Lo que sí sigue en pie es la parte económica del argumento: una vez que uno sabe armar data centers gigantes con muchísimas veces la misma máquina barata, alquilar esa capacidad se vuelve un negocio posible.
La versión documentada es que en 2003 Benjamin Black y Chris Pinkham escribieron dentro de Amazon un documento que proponía una infraestructura completamente estandarizada y automatizada, apoyada en servicios web, y sugería de paso que se podría vender el acceso a esos servidores virtuales; el trabajo arrancó en 2004 y S3 salió en 2006.
Al final de la materia vamos a ver que en Google publicaron una monografía que se llama The Datacenter as a Computer, donde consideran que el data center entero funciona como una especie de computadora gigante. De ahí surgió el orquestador para ejecutar cosas dentro de ese data center, que Google llamó Borg y que años después, liberado como código abierto, se convirtió en Kubernetes.
The Datacenter as a Computer: An Introduction to the Design of Warehouse-Scale Machines, de Luiz André Barroso y Urs Hölzle (2009). Borg es de alrededor de 2003-2004; Kubernetes se liberó en 2014.
Modularidad forzada: aislamiento de fallas y de equipos
Introduzcamos ahora el concepto de la modularidad forzada. Modularizar es algo que ya sabemos hacer desde que empezamos la carrera. Las funciones son una forma de crear módulos —una unidad de código que se reutiliza y que abstrae algo—; las clases también son módulos; y los lenguajes modernos suelen tener además módulos propiamente dichos. Modularizar en esos casos depende de la voluntad, del conocimiento y de la habilidad que uno tenga para diseñar bien, de manera que un módulo no se meta donde no debe y rompa la abstracción. ¿Y por qué queríamos modularizar en primer lugar? Fundamentalmente, para obtener simplicidad en los diseños. Los módulos los necesitamos nosotros: probablemente un modelo de lenguaje no necesite módulos, porque procesa la información de otra manera, pero nosotros, con nuestras limitaciones cognitivas, tenemos que pensar en abstracciones, en módulos que hacen una sola cosa. El problema es que a veces esos módulos tienen fugas, y a veces uno se puede meter y romper esas abstracciones que con tanto cuidado se habían dibujado.
Ahora bien, si en lugar de todo eso usamos sistemas que están físicamente separados, la historia cambia. Si decimos que este es el módulo de la base de datos y que está en esta máquina, y que este otro es el módulo del servidor web y está en aquella otra, ya no hay forma de acceder por otra vía que no sea la interfaz que se pensó para esos dos módulos. No es que meterse por otro lado esté mal visto: es que no se puede. Eso es lo que podemos definir como modularidad forzada, la que logramos rompiendo a la fuerza, físicamente. A veces esas dos máquinas son en realidad máquinas virtuales, pero conviene seguir con el ejemplo de que están físicamente separadas: dos módulos conectados por un cable, y por ese cable tiene que ir una interfaz bien definida. Al forzar esa modularidad, lo que uno logra es compartimentalizar las fallas: que una falla que aparece en un módulo no se propague hasta el otro. Si la base de datos falla gravemente y deja de responder, quizá el servidor web tenga alguna forma alternativa de seguir adelante: quizá guardó algo en una caché, quizá puede funcionar más o menos hasta que la base se restablece. Si en cambio la base de datos estaba junto con el web server en la misma máquina y esa máquina tiene un problema grave, entonces una falla que se originó en el hardware se propagó al resto del sistema. Y de esa compartimentalización de fallas es de donde emerge la propiedad de la tolerancia a fallas. Las cosas son tolerantes a fallas en un sistema distribuido porque fallan parcialmente.
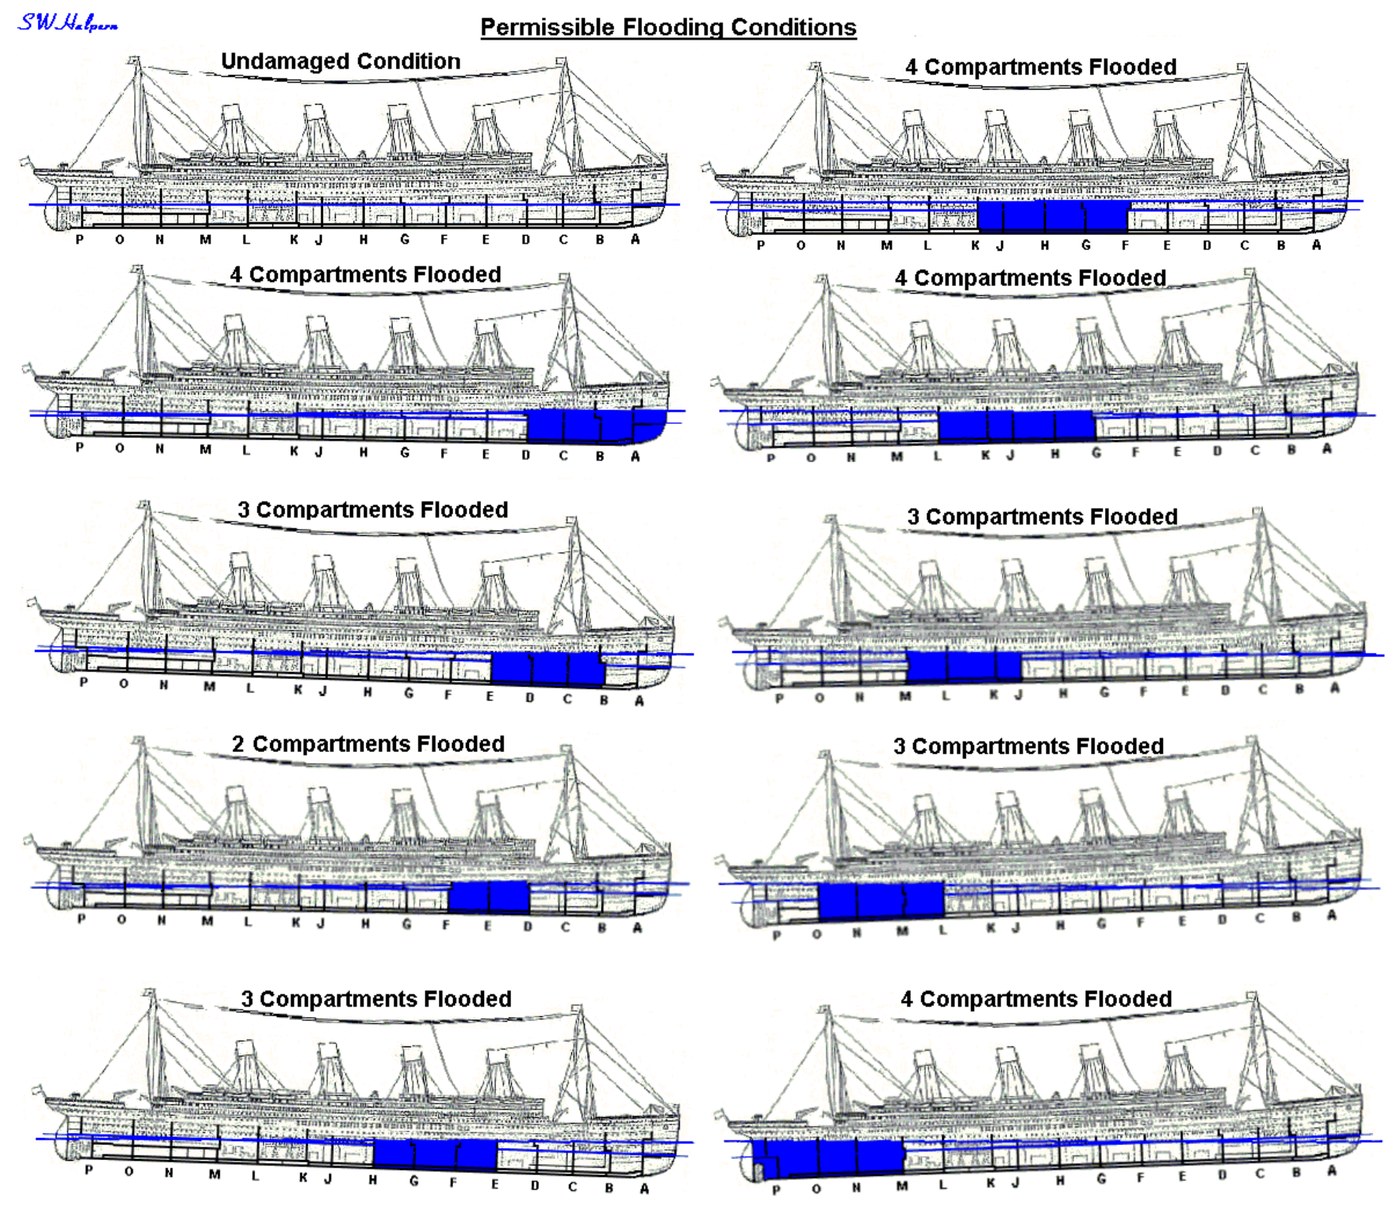
Ilustrémoslo con un ejemplo. En ingeniería naval se utiliza una tecnica para evitar que un choque con un objeto flotante (por ejemplo un iceberg) golpee y rompa el casco del barco, haciendo que se hunda: se divide en muchos compartimentos la parte de abajo, de manera tal que si se rompe una de dichas secciones se inunde sola y no sea suficiente para hundir el barco. La idea que perseguimos nosotros es exactamente la misma: que si falla una parte del sistema falle un nodo solo, y que después el resto se pueda restaurar. Vamos a ver que en general los sistemas suelen tener formas de reemplazar ese nodo y levantar uno nuevo en su lugar, y que eso suele ser automático. La paradoja está en que el barco de la foto es justamente el Titanic, con lo cual la estrategia no les funcionó. El problema fue que el iceberg impactó de costado y rompió varios compartimentos consecutivos: el barco estaba diseñado para flotar con los primeros cuatro inundados, el iceberg le abrió cinco, y ese uno de más alcanzó para hundirlo entero. Y alcanzó por una razón que vale la pena entender, porque es la misma que vamos a ver enseguida en un sistema real: los mamparos que separaban los compartimentos no llegaban hasta arriba, así que con cinco compartimentos llenos la proa se hundía lo suficiente como para que el agua desbordara por encima del mamparo hacia el sexto, y de ahí al séptimo. La falla no se quedó quieta donde empezó: se fue propagando. Se sostiene, inclusive, que el error fue haber intentado esquivarlo: con un impacto frontal, el Titanic podría haberse salvado. Eso es exactamente lo que queremos evitar cuando diseñamos bien un sistema.
El Titanic tenía quince mamparos estancos y podía mantenerse a flote con cualquiera de sus dos primeros compartimentos inundados, o con los primeros cuatro; la colisión abrió costuras y planchas a lo largo de unos noventa metros y dejó abiertos al mar los primeros cinco.
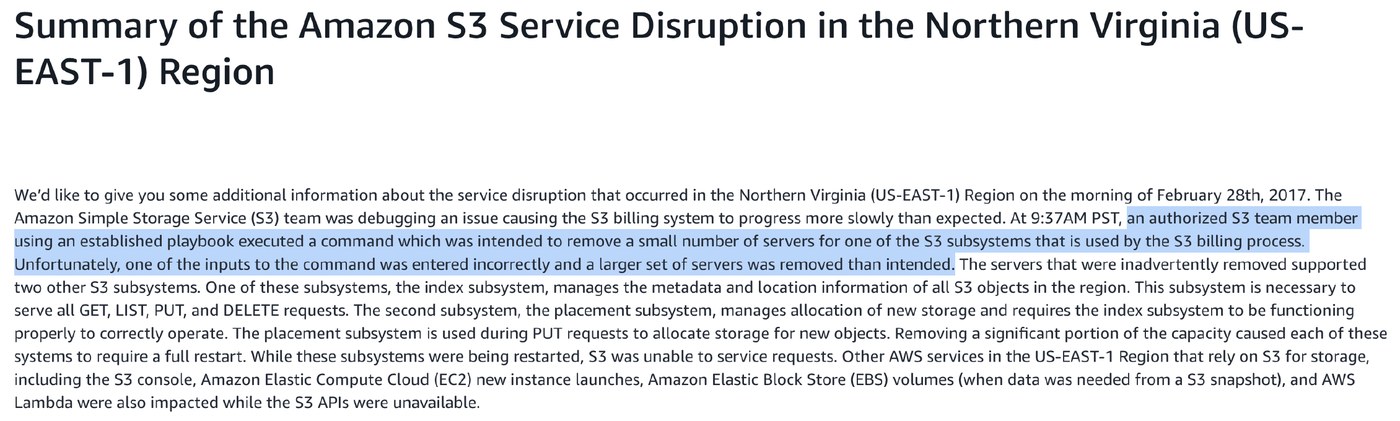
Una versión más cercana de este tipo de fallas ocurrió el 28 de febrero de 2017. S3 es un sistema que se puede pensar como un file system distribuido, pero gigantesco: prácticamente todos los demás sistemas de Amazon dependen de él, y muchísimas otras aplicaciones de internet también. Probablemente sea el storage de archivos más grande que hay en el mundo; se los llama objetos, pero terminan siendo archivos. Naturalmente estaba diseñado con mucha redundancia, con nodos distribuidos por todos lados, de manera que si se rompía uno se restauraba automáticamente. Lo que pasó fue que alguien ejecutó un comando pensado para remover una pequeña cantidad de servidores que querían reemplazar; un error humano condujo a poner mal el número, y ese comando terminó sacando una gran cantidad de servidores del clúster. Y aquí está el parecido con el Titanic: los que quedaban se saturaron y dejaron de responder pedidos, porque no soportaban el resto del tráfico. S3 tenía muchos sistemas que dependían de ese subsistema y que estaban tratando de responder; entonces esos otros sistemas empezaron a fallar, y como no podían responder, la gente les seguía pidiendo cosas y se siguieron saturando cada vez peor. Lo que tuvieron que hacer fue reiniciar todo el sistema, literalmente miles de nodos. Y tuvieron un problema adicional: nunca habían reiniciado S3, así que no estaban muy seguros de cómo levantarlo desde cero. El problema fue tan grande que llegó a los diarios: es el día en que se rompió internet. Quien busque esa fecha va a ver que se cayó cerca de la mitad de internet, una proporción enorme. Se originó por un problema humano, y porque se cayeron muchos más de esos compartimentos de los que se suponía que podían caerse. Lo interesante es que Amazon, cuando comete un error de esta magnitud, publica una explicación para los clientes contando qué fue lo que hicieron, y qué iban a hacer para evitar que el problema se repitiera.
Queda una última ventaja: separar responsabilidades administrativas. Es un argumento que se usa mucho a favor de los microservicios, aunque los microservicios no terminan de convencernos —resulta preferible el concepto de servicios, no tan micro— y esa discusión queda pendiente para más adelante. Lo importante es lo siguiente: si una empresa es grande y tiene muchos equipos, y el sistema es un único monolito acoplado con todo, administrar eso resulta muy complejo desde el punto de vista organizativo. Termina siendo mucho más fácil si las cosas se diseñan como un sistema distribuido donde las interfaces están modularizadas forzosamente: los distintos subsistemas están a la fuerza separados, se comunican mediante interfaces claras que los dueños de cada uno se comprometen a respetar, cada uno puede desplegar de manera independiente, y si algo se rompe se sabe a qué equipo hay que ir. Esa distribución, nótese, ya no es tanto de nodos sino de subsistemas dentro del gran sistema, donde el gran sistema bien podría ser la empresa entera.
Límites de la transparencia
Hay una propiedad más para sumar a la lista, y tiene un carácter distinto de las anteriores: es deseable, sí, pero deseable más o menos. Se trata de la transparencia en la distribución, un punto polémico de entrada, y lo que sigue es una posición tomada, apoyada en algunos papers. Muchas veces los sistemas distribuidos arrancan con la definición de que un sistema distribuido es uno formado por muchos componentes, pero donde ese hecho está escondido: el sistema se ve como uno solo, y los componentes internos no se ven desde afuera. Es casi la definición de sistema con la que empezamos esta lección, aplicada a los sistemas en general y no a los distribuidos en particular.
De ahí surge algo importante: si exageramos mucho con esa transparencia e ignoramos los problemas que tiene la red, todo se nos complica. Y hay un caso histórico que lo muestra.
NFS, el Network File System, fue uno de esos intentos de completa transparencia en la distribución. Era para compartir archivos: uno tenía un servidor donde estaban los archivos, por ejemplo para compartir documentos dentro de una empresa.
Pero la parte esencial del diseño, al menos en las primeras versiones, era que el Network File System se montaba como si fuera un file system más dentro del file system. Es decir, uno montaba el NFS igual que montaría ext4, o NTFS, o FAT.
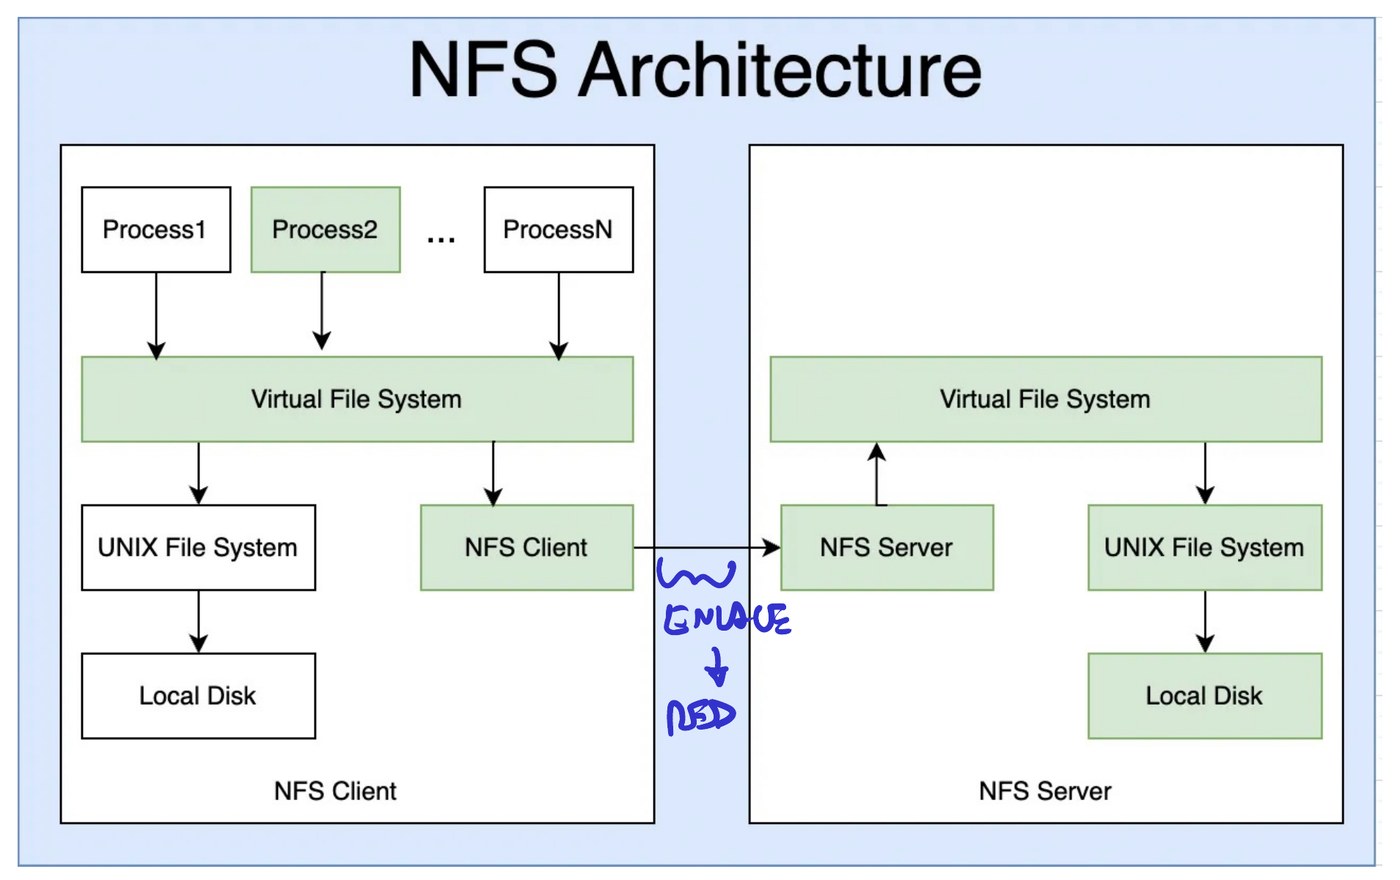
Y lo que terminaba pasando era que cuando todo funcionaba bien, funcionaba bien. Pero aquí está el punto: ese link que une al cliente con el servidor es justamente un enlace de los que veníamos hablando, una de las tres abstracciones. Es una red. Y a veces la red se rompía, se desconectaba, o lo que fuera. La transparencia exagerada de este diseño hacía el resto: una aplicación normal, diseñada para el file system local, si le ponían debajo uno que de vez en cuando fallaba, perdía mensajes o se demoraba sin aviso, funcionaba mal.
Había dos formas en que esto podía tolerar los fallos. Una era fallar directamente y empezar a tirarle errores al proceso. Y conviene ver por qué eso es grave: normalmente, cuando uno escribe en un file system y recibe un error de escritura, es que algo salió muy mal —se quemó el disco, se rompió—, o en el mejor de los casos se acabó el espacio. Uno tiene que manejar el código de error de write porque es lo correcto; en la práctica, si write devuelve un código inesperado, el problema es serio. Con el Network File System esos códigos pasaban a ser casi la norma, porque lo que había abajo era una red que a veces respondía lento y a veces daba timeout. La otra forma de evitar esos errores era peor todavía: que el NFS se bloqueara hasta poder mandar el mensaje. Ahí la idea estaba bien, salvo por un detalle: si el servidor se apagaba y nunca volvía, el programa se quedaba trabado para siempre.
¿Cuál era el problema de todo esto? No un detalle de implementación, sino que exageraron con la transparencia. Tomaron una interfaz, el virtual file system, que asumía ciertas cosas sobre lo que tenía abajo y le pusieron un sistema distribuido debajo. Por eso no tuvo mucho éxito. Vamos a ver que las formas modernas de hacer sistemas distribuidos de alguna manera saben que se están comunicando con algo remoto, y manejan explícitamente los errores que pueden aparecer.
Hay un paper, escrito por Jim Waldo y sus colegas en los laboratorios de Sun, que dice básicamente por qué no se puede exagerar con la transparencia al nivel del NFS —de hecho, el ejemplo del NFS sale de ese paper—. El fondo del argumento es que hay limitaciones físicas que la red impone, y que no se dejan esconder del todo detrás de una interfaz. Estos enlaces tienen cuatro características indeseables que no podemos ignorar, y son exactamente las cuatro que el paper enumera.
A Note on Distributed Computing, de Jim Waldo, Geoff Wyant, Ann Wollrath y Sam Kendall, Sun Microsystems Laboratories, informe técnico SMLI TR-94-29, noviembre de 1994. Las cuatro que enumera son latencia, acceso a memoria, concurrencia y fallas parciales.
La primera es la latencia. En general las redes son más lentas que escribir directamente en el disco, pero lo que más importa no es tanto que sean lentas sino que tienen mucha varianza. Los links dentro de un data center son muy rápidos, solo que no son tan constantes como escribir en un disco. Depende de si un router se rompió, de si pasó algo raro, o de si el host al que nos queremos conectar está cerca o lejos —y en general ni siquiera sabemos dónde está físicamente— y tiene que dar muchos saltos. Y por eso, para un diseñador, es mucho más difícil asumir garantías sobre cuál es un timeout apropiado. Si ponemos un timeout de 10 milisegundos estamos muy justos: muchas veces la red va a tardar más por una cuestión perfectamente normal, y vamos a recibir un error que no corresponde a ninguna falla. Cuán justos estamos se ve poniendo números. La luz viaja por una fibra óptica a unos doscientos mil kilómetros por segundo, y de Buenos Aires a Virginia hay unos ocho mil kilómetros; el ida y vuelta, entonces, no puede bajar de ochenta milisegundos, y eso suponiendo que el cable va derecho y que ningún equipo intermedio se toma un instante para pensar. Con un timeout de diez milisegundos, ninguna llamada a otro continente llegaría jamás a tiempo: estaríamos declarando caído un servidor que funciona perfectamente, por pedirle algo que la física no permite. Si en cambio lo ponemos demasiado largo, el precio es el opuesto: cuando algo efectivamente falle, muchas aplicaciones se van a volver lentas.
La segunda es el memory access, y es igual de clave. Cualquier intento de ignorar el problema y suponer que podemos compartir memoria entre dos sistemas que no están físicamente en la misma máquina nos va a llevar por mal camino. Si no es la misma memoria, cuando la tratemos de compartir va a resultar lento y van a aparecer errores de concurrencia.
La tercera son las fallas parciales, y pesan especialmente en los sistemas grandes: las cosas fallan constantemente, la red falla, fallan los routers, fallan los discos. En una máquina física que está toda junta la probabilidad de que las cosas fallen es relativamente baja; una computadora puede pasar años sin fallar, justamente porque es una sola pieza. Pero si tuviéramos mil computadoras, por una cuestión de probabilidad alguna estaría fallando constantemente. Y conviene hacer la cuenta, porque el resultado no es intuitivo: si cada máquina aguanta tres años sin romperse —que es una vida razonable y hasta modesta—, mil máquinas juntan trescientas treinta y tres roturas por año, es decir casi una por día. La misma pieza de hardware que individualmente parece indestructible se convierte, multiplicada por mil, en una falla diaria.
La cuarta es la concurrencia. Necesariamente todas las cosas van a ejecutarse concurrentemente: cada uno de estos nodos tiene un procesador propio y está siempre haciendo cosas. Y la concurrencia, combinada con el memory access, nos saca algo que antes nos venía muy bien: los locks basados en memoria compartida. Los mutexes, los semáforos, todas esas herramientas, si uno se mete a ver cómo están hechas, se basan en poder compartir memoria: terminan apoyándose en alguna operación atómica del procesador, del tipo de la que suele llamarse CAS, por compare-and-swap —comprobar un valor de memoria y fijarlo—, diseñada para que si hay varios procesadores solamente uno pueda ejecutarla atómicamente. Como ahora los procesadores están separados, vamos a tener que recurrir a otros mecanismos para implementar la funcionalidad que tenían los locks. Una transacción en una base de datos ya no va a ser tan fácil, y por eso vamos a dedicarle una clase entera a ver cómo funcionan las transacciones.