2. Sharding
El sharding es parecido al particionado de un cómputo en muchas partes, pero con una diferencia decisiva: aquí lo que se parte no es un cómputo, sino un conjunto de datos. Representémoslo como una gran columna, un dataset abstracto: una cantidad enorme de datos y nada más. Puede ser un ZIP que contenga toda la web o cualquier otro conjunto: al sharding no le importa de qué están hechos los datos, le importa que haya muchos. Quizás lo más fácil de imaginar es una tabla gigantesca con mil millones de registros, donde cada interacción de un usuario genera un evento. Conviene hacer la cuenta, porque es la que fuerza todo lo demás: si cada evento ocupa un kilobyte, mil millones de eventos son un terabyte, y ya estamos discutiendo si eso entra en el disco de una máquina. Y un detalle clave: esa es una tabla lógica, no una que esté físicamente en una máquina en particular.
Eso es concretamente el sharding. Esa tabla se particiona de alguna forma en fragmentos, y cada fragmento termina en una máquina independiente. Y eso nos da directamente el escalado horizontal: cuando el sistema crece, agregamos más máquinas y repartimos los datos entre ellas.
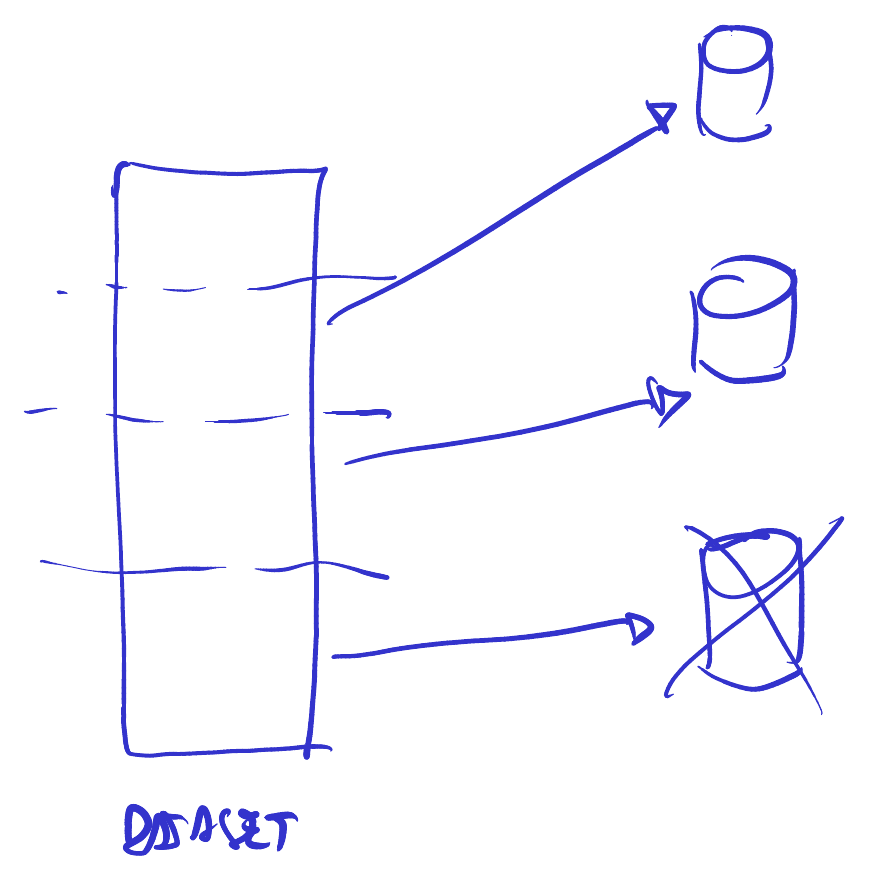
La forma debería resultarnos intuitiva. Si alguien nos dijera que la base no entra en el disco y que la tenemos que dividir, la primera intuición de cualquiera sería tomar las tablas y dividirlas: si fuera relacional, enviar distintas tablas a distintos lugares. La otra posibilidad es dividirlas por dentro, como en el dibujo, basándose en alguna clave.
Basándose en qué concretamente, ahí no hay respuesta única y el tema es muy amplio. Quizás en Programación Concurrente ya nos cruzamos con un esquema de hash consistente. Cuando veamos Dynamo vamos a comprobar que resuelve el sharding usando las claves: le calcula un hash a la clave y decide con eso en qué fragmento cae el dato.
Pero cualquiera sea el criterio, tiene que haber un mecanismo de nombres, y cada sistema lo resuelve de manera distinta. Lo que ese mecanismo hace es tomar cada dato individual —o cada registro, aunque al decir “registro” ya nos restringimos a un vocabulario de base de datos: Google File System no tiene registros, sino archivos partidos en fragmentos de 64 MB— y mapearlo a su ubicación física. Sin ese mapeo el particionado no serviría de nada: tendríamos los fragmentos repartidos y ninguna manera de saber a qué máquina ir a buscar un dato.
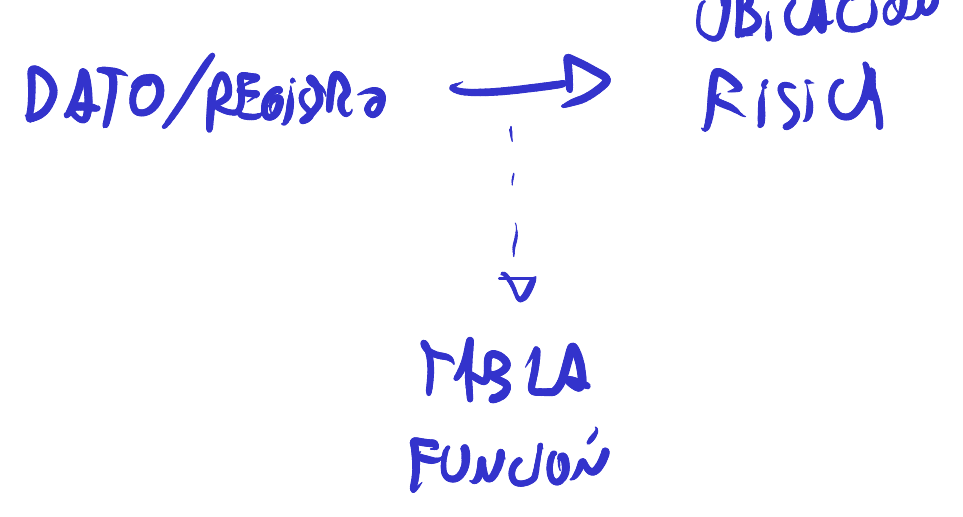
Esa flecha la podemos pensar de dos maneras: como una tabla o como una función, y con esas dos alcanza para cubrir casi todos los sistemas que vamos a analizar. En el hash consistente el mapeo consiste en tomar el dato, extraer su ID, calcular el hash y ver en cuál fragmento del anillo cae; ahí no hay nada guardado, es puro cálculo. Pero bien podría ser lo otro: en Google File System hay todo un sistema que guarda, para cada archivo y cada fragmento de 64 MB, en cuáles máquinas físicas se aloja. Ahí el mapeo es una tabla que alguien tiene que mantener.
Ahora la pregunta que importa: ¿qué logramos con el sharding? Varios beneficios, y vale la pena ponerlos uno al lado del otro, porque el primero es evidente y los otros dos no tanto.
El primero es la escalabilidad, y en particular la horizontal. Recordemos que era horizontal versus vertical: si la máquina que ejecuta Postgres nos resulta insuficiente, la reemplazamos y copiamos la base a una más grande, y eso es vertical. Horizontal es agregar máquinas en paralelo. No es trivial, pero si damos con alguna forma de shardear los datos, ya la conseguimos.
Esa parecería la única razón, pero hay otros beneficios. Con el sistema shardeado obtenemos automáticamente una propiedad que se llama fallas parciales. Si falla una instancia —la máquina tachada del dibujo— y el resto de los clientes no necesitan justo ese fragmento ni realizan joins que crucen shards —algo que de por sí ya es complicado aquí—, esos clientes ni siquiera lo advierten: siguen usando el resto. Los que sí accedan a ese fragmento van a notar el problema y, hasta que se restaure, van a ver una baja en la disponibilidad. Pero se dice que el sistema está degradado, no caído por completo.
Y hay experiencia de campo detrás, no es solo un argumento teórico. En Amazon había casi una obligación de no usar una base única en una única máquina, y no tanto por la escalabilidad sino porque lo que más interesaba era la alta disponibilidad: no se quería que, si las cosas fallaban, fallaran completamente.
Vamos a ver también que en varios de estos sistemas —especialmente los que no son full relacionales— la recuperación de fallas es más rápida y fácil de implementar: muchos se restauran mucho más rápido que una máquina que se cae y hay que levantar una copia. Pero eso viene más adelante.
El nombre, de todos modos, promete más de lo que da: las fallas parciales son un subproducto del sharding, no su objetivo. Ya obtenemos parte de la tolerancia a fallas simplemente al dividir el problema en fragmentos, pero la técnica por excelencia para la tolerancia a fallas es la replicación.
Queda un tercer beneficio, el paralelismo de acceso. Un sistema que consume muchos datos de muchos lugares puede acceder a distintos shards en simultáneo, y ahí obtiene más capacidad de respuesta: el throughput —la cantidad de datos por segundo que nos devuelve— es mayor, simplemente porque paralelizamos el acceso. Algo de esto es la estrategia que usa MapReduce con Google File System, que vamos a ver la semana que viene.
De modo que shardear no es solo por escalabilidad horizontal ni solo por las fallas parciales que se obtienen como consecuencia: además nos da un beneficio de performance. Y en todos estos papers vamos a ver que se mencionan estos tres beneficios, de una forma u otra, cada vez que se particionan los datos.