3. Anti-entropy y Merkle trees
En esta sección
Comparación de réplicas
Encima del hinted handoff hay otro mecanismo para mantener las réplicas sincronizadas, por si falla el quórum o cualquier otra cosa. Y llamarlo “mecanismo” es casi exagerado: no es un sistema aparte, sino las réplicas mismas comunicándose periódicamente entre sí y dándose cuenta de que tienen que actualizarse. Llamémoslo sincronización directa entre dos réplicas.
Primero hay que aclarar que las dos réplicas no van a ser exactamente iguales, ni tienen por qué serlo: cada una tiene claves que no están replicadas del otro lado. Cada máquina sabe perfectamente qué claves le corresponden. Así que cuando dos réplicas se comparan, lo hacen inteligentemente: para saber si las claves que deberían estar están, y si están en la versión correcta, de manera que las dos converjan al mismo estado.
Imaginemos entonces la tabla de claves y valores de Dynamo, una para el servidor uno y otra para el servidor dos, enfrentadas.
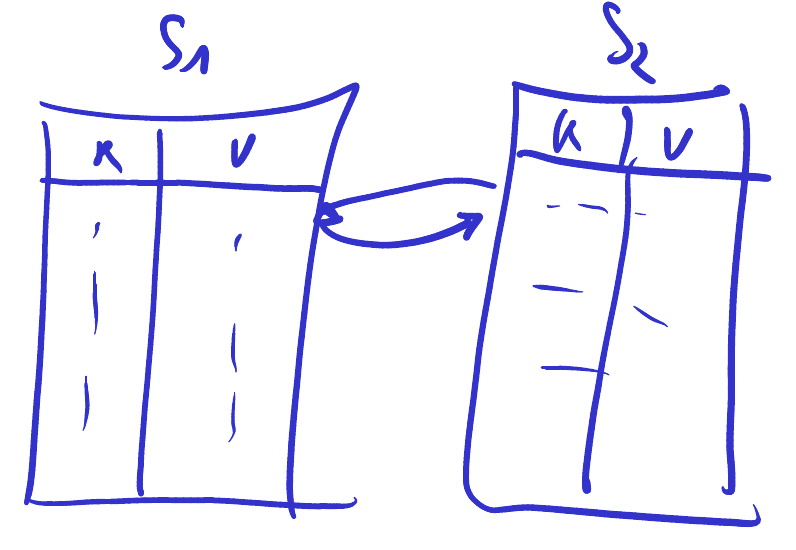
La forma obvia de compararlas es un bucle muy ineficiente: uno le pregunta al otro cuánto vale una clave, el otro le devuelve el valor, y así se van sincronizando de a un valor por vez. Es la versión fuerza bruta de comparar dos tablas potencialmente gigantes. Y ese es el problema: potencialmente gigantes. Implica transferir la tabla entera de un lado al otro y de vuelta: con un millón de filas, son dos millones de filas cruzando la red para descubrir, con suerte, que no había ninguna diferencia.
Además, la mayoría de las veces esa comparación va a ser innecesaria, porque el sistema va a estar funcionando bien. Solo tras una falla rara, o una combinación de fallas, aparecen discrepancias. Estaríamos saturando la red y tardando mucho para atender un caso especial, cuando lo común es que las tablas estén iguales o difieran en un par de valores.
Checksums y Merkle trees
El algoritmo que se usa es interesante por sí mismo, porque aparece en otros lugares: los árboles de Merkle, Merkle trees. Git se basa en esto, aunque no en los detalles —lo que arma Git no es un árbol binario de hashes como el que vamos a construir, sino un grafo dirigido acíclico en el que cada objeto se identifica por el hash de su contenido y cada commit incluye el hash de su padre—, y Bitcoin y Ethereum también los usan, este último con una variación más compleja. Sirven para comparar grandes estructuras de datos, incluso archivos enteros; con una tabla la idea es más fácil de entender.
Imaginemos una tabla de unas ocho filas. Para comparar una sola fila ya tenemos la intuición: si le calculamos el MD5 —o cualquier otro hash— y en la otra tabla da el mismo valor, las dos filas son iguales. Es lo mismo que comparar checksums, como cuando bajamos un archivo y nos dan su MD5: podemos verificar si esa imagen de CD, ese instalador o ese tarball llegó corrupto sin comparar el archivo entero.
El final del razonamiento se ve antes que el principio. Para saber si dos tablas enteras son iguales, la primera intuición sería calcular el hash de cada tabla completa y compararlos. Si son iguales, no hay nada que hacer. Si son diferentes, habría que comparar fila por fila. Es lo mismo que pedirle al servidor el hash de un archivo, calcular el nuestro y compararlos.
Los Merkle trees son más astutos: no solo dicen que las tablas difieren, sino exactamente cuáles filas son las diferentes. Para eso construyen un árbol de hashes. A cada fila le calculan su hash, y después unen esos hashes de a pares: el hash de los dos hashes. Si alguno de los de abajo se modifica, el de arriba también. Y así nivel por nivel, uniendo de a pares hasta que queda un solo hash en la punta. Si la cantidad de filas es impar —y en nuestro ejemplo lo es—, la última queda sin par y sube sola.
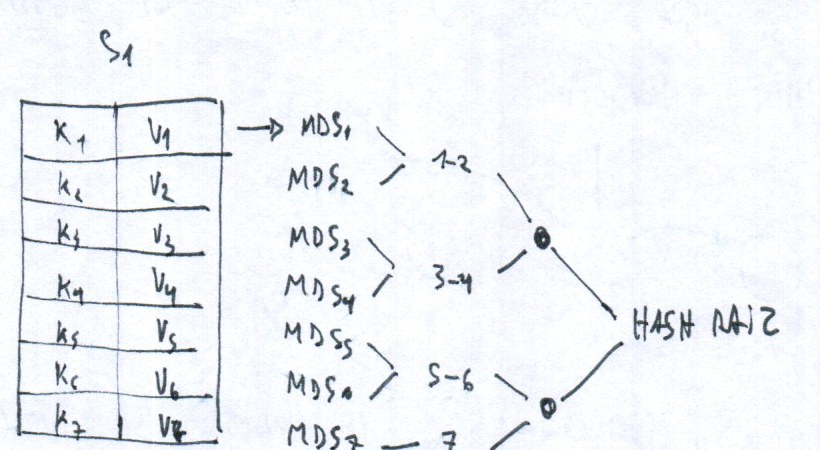
El hash de la punta no es el mismo que daría calcular el hash de la tabla entera de una vez, pero funciona igual.
Búsqueda de diferencias en el árbol
Si la otra tabla usó el mismo procedimiento, la comparación se vuelve un descenso. Empezamos por arriba: si los dos hashes de la punta son iguales, las dos tablas enteras son iguales. Si difieren, miramos el segundo nivel. Si los dos primeros nodos coinciden, toda esa mitad de la tabla es igual, y descartamos la mitad del problema. Si los otros dos difieren, miramos sus hijos, y los hijos de esos, hasta llegar a los que son diferentes.
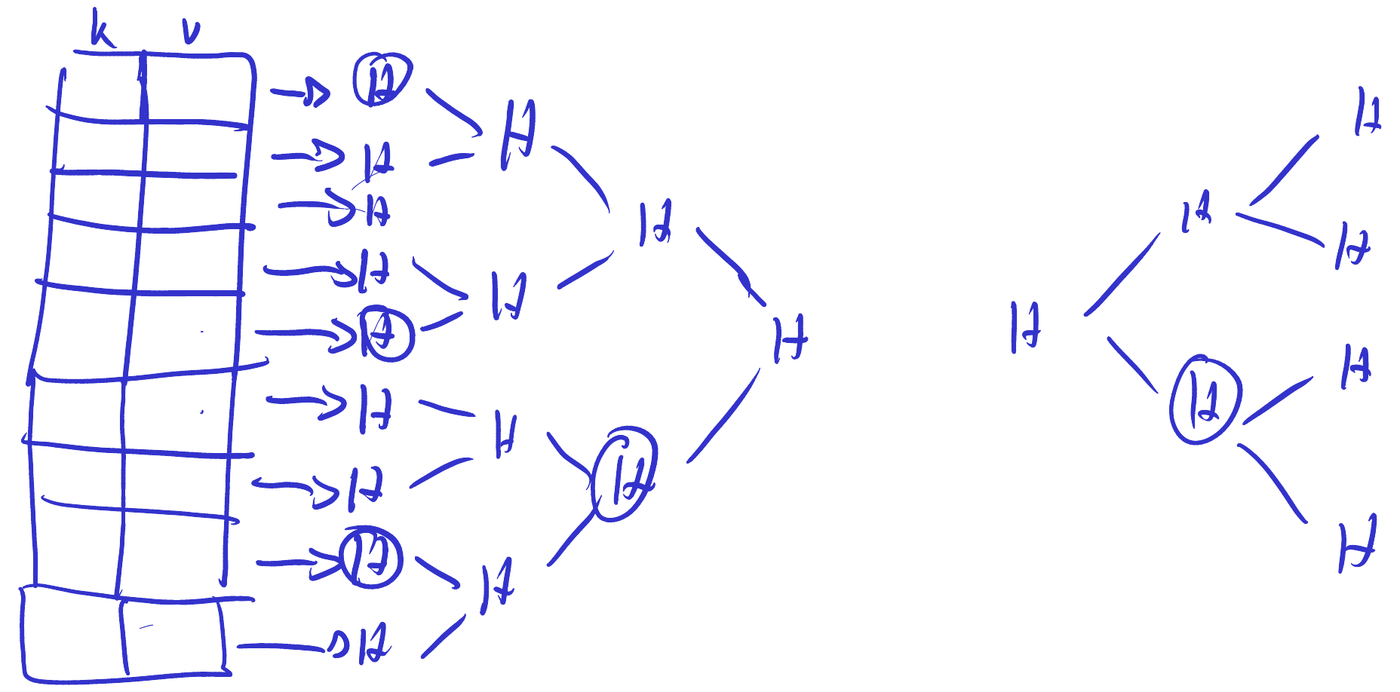
Nos metemos por el árbol en orden logarítmico, y al final vemos exactamente qué filas difieren. Ese orden logarítmico cambia la escala del problema. En la tabla de un millón de filas, la fuerza bruta transfería dos millones de filas; el descenso baja veinte niveles —el logaritmo en base dos de un millón es casi exactamente veinte— y en cada uno compara un par de hashes. Cuarenta hashes de treinta y dos caracteres son algo más de un kilobyte de tráfico, y contestan la misma pregunta que la fuerza bruta contestaba mandando la tabla entera dos veces. Después solo hay que transferir esa fila, ver con los relojes vectoriales cuál versión está más actualizada, y actualizar. Y esto se hace constantemente.
No es evidente que sea la forma matemáticamente óptima de comparar dos tablas, y probablemente no lo sea. Pero funciona. No es un tema tan “sistema distribuido” como el resto, aunque aparecía en la tabla del paper y valía la pena estudiarlo.