5. Integración con MapReduce
Estos dos sistemas se combinaban de una manera muy inteligente. La idea quedó anunciada al pasar cuando seguimos una lectura de punta a punta: el cliente elige el chunkserver más cercano, ese chunkserver puede estar corriendo incluso en la misma máquina, y eso lo hacen a propósito.
Lo que hacían en esa época, por lo que se describe principalmente en el paper de MapReduce, era poner en la misma máquina un worker de MapReduce y un chunkserver. Imaginemos un host físico y, dentro de él, dos programas que en principio no guardan relación entre sí: un map worker y un chunkserver. Ese host tiene un disco, y en ese disco están los chunks, gobernados por el chunkserver. Afuera, en otras máquinas, están el master de MapReduce y el coordinador del GFS.
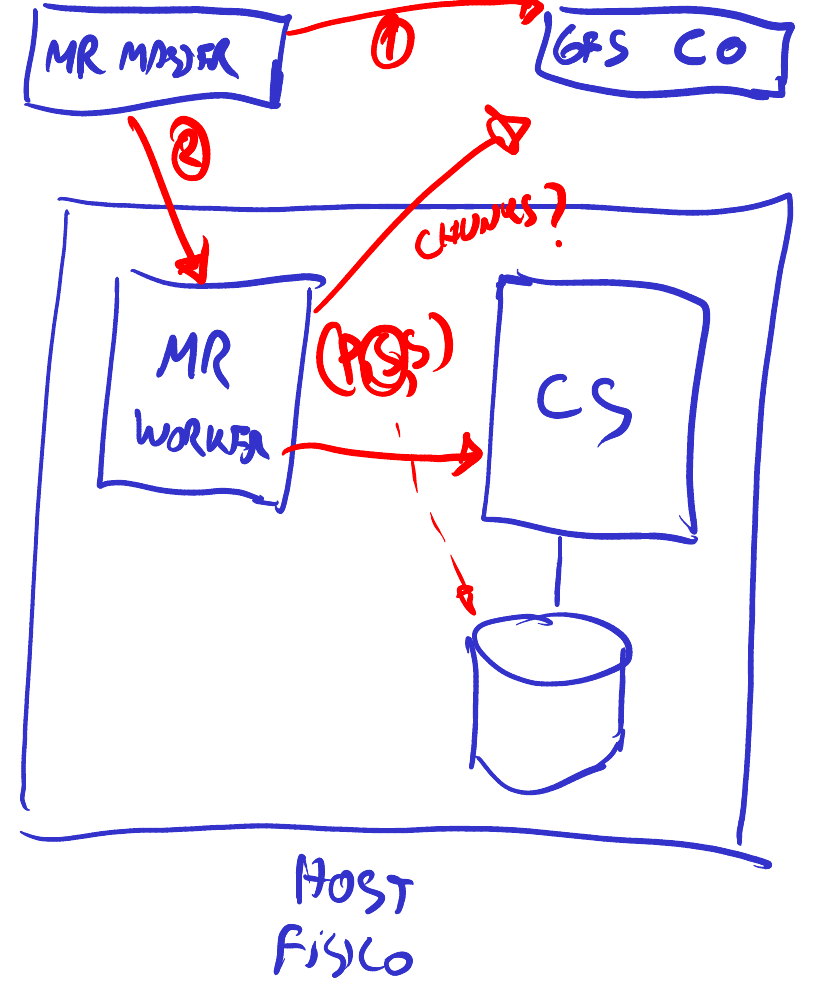
Y la idea es la siguiente: si el master de MapReduce es astuto, puede asignar los mappers no al azar sino selectivamente, ubicándolos donde ya se encuentra el chunk que van a necesitar. Es la diferencia entre repartir el trabajo a ciegas y repartirlo sabiendo de antemano dónde están los datos.
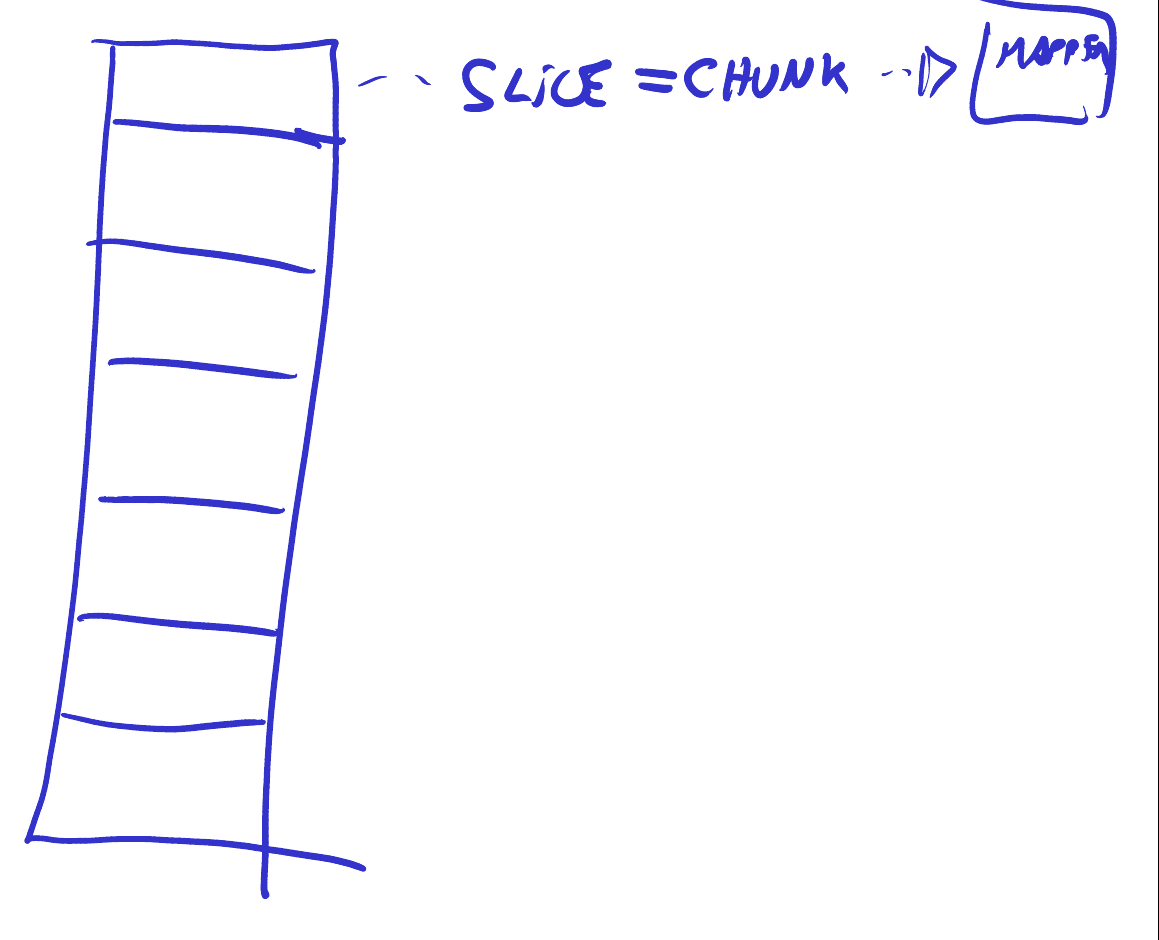
Este punto no está del todo documentado; no se habla mucho de cómo se particiona el input que se les da a los mappers. Pero en algún lado se dice que una forma de particionar ese trabajo inicial es usar directamente los slices —el término que usaba MapReduce para cada pedazo del input— y que cada slice sea directamente un chunk. Si un archivo grande vive en el GFS y está partido en chunks, cada chunk se mapea directamente con un mapper: un archivo de 100 chunks, 100 jobs de tipo mapper.
Lo que hace entonces el master de MapReduce al seleccionar qué le toca a cada quien es preguntarle al coordinador del GFS, para el archivo que tiene que particionar y repartir, en qué lugares físicos están las réplicas de esos chunks. Con esa información hace una selección afín de cada worker con los chunks que ya están ahí: le asigna algo que sabe que tiene localmente.
Después el worker, que va a actuar como un cliente común del GFS, le pregunta por los chunks al coordinador, que le responde lo de siempre: el primary, un secondary, otro secondary. Pero puede ocurrir que uno esté justo donde el worker se está ejecutando, y entonces lo aprovecha: al estar local, no necesita conectarse por la red.
Esto es best effort: el sistema trata de hacerlo lo mejor posible, no lo garantiza. Pero si funciona, buena parte de ese tráfico inicial se evita: todo ese flujo enorme que tenía que viajar por la red se resuelve localmente, con dos capas de abstracción que colaboran entre sí. Quien implementó el map y el reduce no se tiene que preocupar por nada de esto ni por cómo se distribuyen los archivos. Los dos sistemas trabajan en combinación para minimizar el tráfico por la red, que era justamente lo que los de Google querían evitar.
Del otro lado pasa lo mismo: cuando se asigna un trabajo de reduce, se lo hace a propósito para que el reducer escriba en un chunk que esté local.
Hasta qué punto lo hacían exactamente así no está documentado, de manera que esto no sale de una descripción textual. Pero tampoco es una conjetura infundada: ellos sí afirman que ubicaban los chunkservers y los workers juntos para aprovechar esas localidades. Con ese dato alcanza para reconstruir el resto, y una vez que se lo comprende, resulta simple y elegante.