1. Sistemas de storage
Storage es el término amplio con el que vamos a referirnos a los sistemas de archivos y a las bases de datos, y es un terreno con el que ya estamos familiarizados aunque no lo llamemos así: el sistema de archivos de Unix es storage, y Postgres también. A diferencia del tema de la clase anterior, que pertenece al cómputo —realizar un cómputo grande y repartirlo—, los sistemas de storage son considerablemente más complejos: se les puede dedicar un curso entero y aun así quedan temas sin tratar. Nosotros vamos a dedicarles varias clases.
La pregunta inicial es por qué querríamos construir un sistema de storage distribuido. Los objetivos posibles son muchos, pero hay dos que concentran la motivación: la escalabilidad y la tolerancia a fallas. Y lo son porque un sistema de storage local siempre va a ser más simple; en general cualquier sistema en una única máquina lo es. Así que cada vez que nos preguntemos por qué construimos algo distribuido, la respuesta va a caer casi siempre en esas dos categorías. A veces se suma la distribución geográfica, pero el fondo es querer escalabilidad —en particular horizontal: agregar más máquinas y que la potencia aumente— y tolerancia a fallas.
Esa segunda motivación se abre en dos, porque en storage hay dos peligros distintos que queremos tolerar. Uno, más que tolerancia a fallas propiamente dicha, es alta disponibilidad: que el sistema esté siempre disponible, que no se interrumpa, o que si se interrumpe se restaure automáticamente. El otro es específico del almacenamiento y es quizás el más importante: que no se pierda ningún dato. Es lo que sí puede ocurrir con una máquina individual a la que se le rompe el disco. Un sistema distribuido promete ser mucho más tolerante a la pérdida de datos.
Conviene mirar hacia atrás, porque ya vimos un sistema que perseguía estos mismos objetivos: MapReduce. No es storage —es cómputo—, pero también buscaba tolerancia a fallas y, principalmente, escalabilidad. ¿Cuál era su estrategia? Interpretar el problema como algo que se puede particionar en muchas partes pequeñas y enviar cada una a una CPU distinta. Es divide y vencerás, pero con una diferencia de propósito que vale la pena marcar: en las primeras materias de la carrera dividimos para simplificar el algoritmo, como en quicksort. Aquí dividimos explícitamente para poder paralelizar.
Pensemos en el ejemplo canónico: indexar la web. Tenemos un file system gigante con una enorme cantidad de páginas y las tenemos que indexar todas. Lo particionamos, cada máquina recibe un décimo del problema, y ejecutamos las diez partes en paralelo. Eso nos da escalabilidad horizontal: si el input crece, agregamos más máquinas y se resuelve. Y una variación de ese particionado también existe para los sistemas de storage.
La tolerancia a fallas en los sistemas de cómputo también era sencilla. ¿Cuál era el secreto para que, si falla una de las partes, no hubiera que comenzar todo de nuevo? La primera mitad de la respuesta es que la falla es parcial: lo que falló es solo esa parte. La segunda mitad es más simple todavía: reintentamos. Con eso solo lográbamos la tolerancia a fallas, ignorando que si fallaba el coordinador fallaba todo y había que idear algún mecanismo para cubrir ese caso.
Pero conviene subrayar un detalle: eso no era automático. Quien enviaba el job, al diseñar el map y el reduce, tenía que tener en cuenta que tanto los mappers como los reducers podían llegar a ejecutarse varias veces. De ahí la exigencia de que esos cómputos fueran deterministas, y para serlo no podían depender de un estado: solo con el input y el algoritmo, el output tenía que ser siempre el mismo. Dicho de otro modo, tenían que ser stateless. Y eso no es automático: si no se presta atención, cada cómputo podría requerir la hora y, en función de ella, hacer una cosa u otra, y ahí se termina el determinismo. Muchos de los sistemas que vamos a ver, cuando el problema es computar en paralelo, se resuelven así: haciendo que cada partición sea determinista y reintentando cuando algo falla. Era un recurso eficaz, y nos resultaba suficiente.
En un sistema de storage no vamos a poder recurrir a este tipo de estrategias. Un sistema de storage existe porque tiene estado: de la misma forma en que los mappers y los reducers son stateless, los sistemas de storage son puro estado. De hecho materializan, si recordamos la primera clase, una de aquellas abstracciones básicas: la memoria dentro de un sistema distribuido. Un file system es una abstracción de memoria; una base de datos también. Y todos los problemas que vienen de aquí en adelante surgen de ahí.
Por eso siempre que se construye un sistema distribuido reaparece la misma escena. El ejemplo de la primera clase era un web server que guarda datos en una base de datos: si queríamos escalarlo, poníamos muchos servidores, un load balancer adelante, y del otro lado la base de datos.
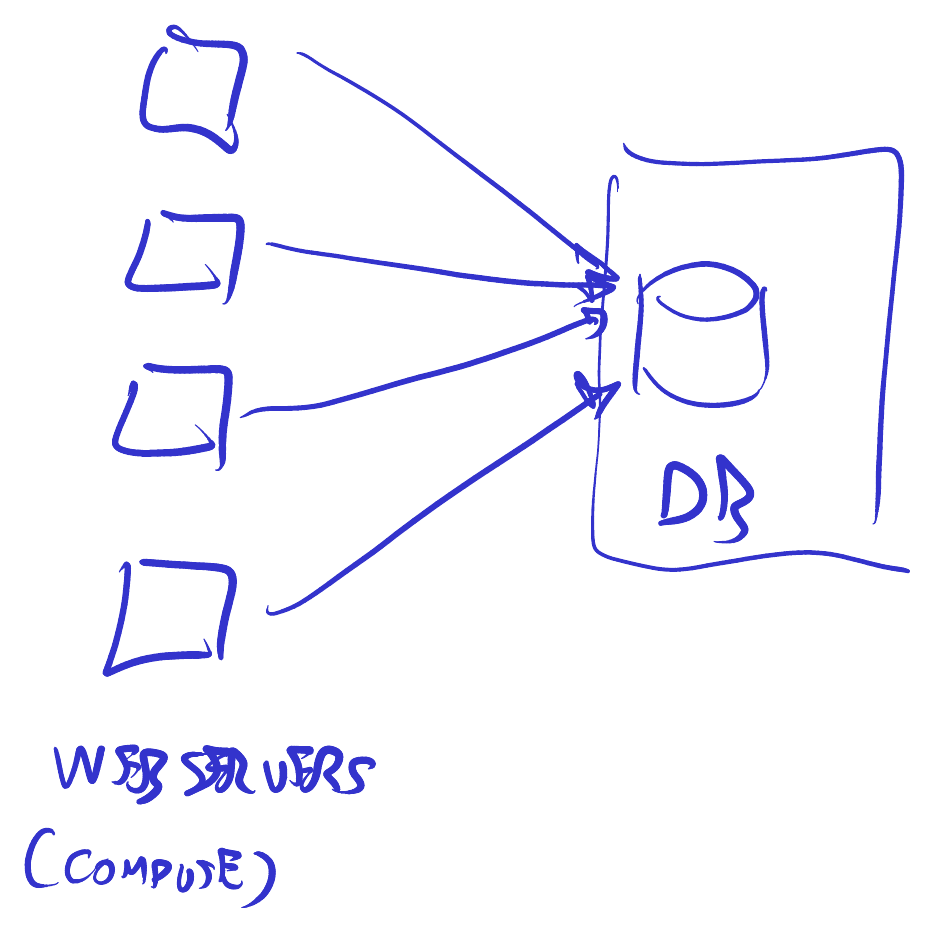
Esa primera parte es muy sencilla: los web servers resuelven el problema de cómputo, sirven los datos e implementan las conexiones con el cliente. Pero todos se tenían que conectar a una base de datos, y ahí dividirla en partes no era nada trivial. De hecho, cuando hoy decimos “DB” ya rara vez hablamos de una máquina tipo PC con una base de datos en su interior: eso suele ser un sistema, en el sentido preciso de aquella abstracción que ya definimos, una caja que contiene numerosos mecanismos para ser tolerante a fallas y escalable.
Y en general esa parte se delega a Amazon o a Google, precisamente porque es la difícil. Uno programa su servidor en Node o en Java, lo particiona, solicita cinco réplicas, se sobrecarga y solicita diez; pero la base de datos siempre es una pieza más oculta.
Vamos a invertir muchas clases en ver cómo se resuelve eso, y debería ser evidente por qué hace falta tanto: porque no se trata simplemente de replicarla. Si guardamos a veces un dato en una base y a veces en otra, ¿cómo hacemos después para encontrar en cuál está cada cosa?
Hay dos técnicas principales para conseguir todo esto, tanto en bases de datos como en file systems. Una es el particionado, con alguna variación respecto de MapReduce, también llamado sharding; la otra es la replicación. Son cosas diferentes, pero suelen aparecer combinadas. Vamos a ver tres o cuatro ejemplos de cómo distintos sistemas particionan los datos y los replican para lograr escalado y tolerancia a fallas.