2. Control de concurrencia y two-phase locking
En esta sección
Control de concurrencia pesimista y optimista
El concepto de serializabilidad es exactamente el mismo para las transacciones distribuidas. Uno esperaría que conseguirlo también fuera fácil, y no lo es; el tema es más complejo de lo esperado. Quien haya estudiado el tema va a reconocer lo que viene. El tema se llama control de concurrencia, y hay dos grandes categorías: la pesimista —un nombre algo curioso— y la optimista.
La pesimista es históricamente más vieja y la más familiar, porque funciona con locks. Hay de varios tipos —quien vio bases de datos conoce los de lectura-escritura y los de solo lectura—; nosotros vamos a ver la versión fácil, un lock de escritura para todo. Y vamos a ver el algoritmo fundamental, el two-phase locking. No es lo central de hoy, pero importa para la clase que viene: Spanner, la base de datos de Google, usa locking pesimista y hace two-phase locking. Conviene escribirlo con una advertencia pegada al lado: two-phase locking no es two-phase commit. El two-phase commit es el otro gran tema de la clase, y los nombres se parecen lo suficiente como para confundirse todo el tiempo.
No fue el único que trabajó en esto, pero el más relevante fue Jim Gray, y el algoritmo es de 1976. Gray ganó el Turing Award —algo así como el Nobel de la computación— en 1998 por su trabajo en bases de datos, y escribió con Andreas Reuter un libro, Transaction Processing, algo desactualizado pero todavía la referencia del tema.
El paper canónico del two-phase locking es The Notions of Consistency and Predicate Locks in a Database System, de K. P. Eswaran, J. N. Gray, R. A. Lorie e I. L. Traiger (CACM 19(11), noviembre de 1976): Gray es uno de cuatro autores. El libro es Transaction Processing: Concepts and Techniques, de Jim Gray y Andreas Reuter (Morgan Kaufmann, 1992). La cita del Turing Award de 1998 es “for seminal contributions to database and transaction processing research and technical leadership in system implementation”.
Tiene además una historia trágica. A Gray le gustaba navegar, y el 28 de enero de 2007 salió solo en su velero desde la bahía de San Francisco, rumbo a las islas Farallón, a esparcir las cenizas de su madre por el mar. Desapareció y nunca lo encontraron. Hubo gente del ambiente que armó sistemas para analizar fotos satelitales del mar frente a la costa de San Francisco, sin resultado, y no fue hasta enero de 2012, cinco años después, que lo declararon legalmente muerto. Era una figura casi tan importante como Lamport pero para el mundo de las bases de datos: el que más contribuyó al tema de las transacciones.
Bloqueo frente a reintento
Volvamos a las dos categorías. El locking optimista es, justamente, el que no usa locks, y se define sobre todo por eso: nadie se queda esperando. Hay una asimetría: para el pesimista no hay muchas formas —es two-phase locking y listo—, mientras que para el optimista hay muchísimas. Los primeros en proponerlo fueron Kung y Robinson, en 1981; ese es el paper para quien quiera profundizar.
El pesimista tiene dos características importantes. Usa locks, y eso implica que los clientes esperan, se bloquean o implementan la espera de alguna forma. Si obtengo el lock —un mutex— sigo adelante; si no, me quedo bloqueado esperando que el sistema de locks me responda. Eso mismo se termina usando en sistemas distribuidos.
El optimista es lo contrario. No hay locks en el sentido tradicional. Se llama optimista porque asume que no va a haber conflictos, que va a poder realizar la transacción. La verificación se hace antes del write, en sentido amplio —no necesariamente antes del commit, porque en el two-phase commit esa verificación cae en otra fase—, pero antes de que el dato quede persistido hay que verificar que ninguna otra transacción haya interferido. Si la verificación da OK, se continúa. Si no, abort y retry. El sistema le traslada la responsabilidad al cliente: no le acepta la transacción, le devuelve un error, y queda de su lado reintentar.
Lo principal es que acá no hay espera, y de ahí se sigue otra consecuencia: no hay deadlock. Los deadlocks se ven en sistemas operativos y en Programación Concurrente, así que sabemos de qué se trata: si nadie espera por nadie, nadie puede quedar bloqueado esperando. Es una gran ventaja de implementación, aunque no para el cliente, que ahora tiene que hacer los retries.
Fases del two-phase locking y ubicación de los locks
El two-phase locking tiene, lógicamente, dos fases: la expansiva o growing y la contractiva o shrinking —la traducción no es del todo estándar, así que conviene quedarse con los nombres en inglés—.
El algoritmo es simple. Antes de acceder a un dato, para leerlo o escribirlo, hay que obtener el lock. Hay variantes: se puede obtener la primera vez que se va a leer o escribir el valor, o, si uno puede preescanear todo lo que va a necesitar, pedirlos todos juntos al principio. Eso no cambia el algoritmo. Lo importante es otra cosa: cuando se libera uno, ya no se puede pedir ningún lock nuevo. El primero que se libera hace entrar en la fase de liberación, y a partir de ahí no se puede pedir otro.
Hay varias versiones de en qué momento exactamente hacer esto. En todos los ejemplos vamos a usar una que tiene dos nombres: two-phase locking riguroso, o strict strong two-phase locking. La secuencia es begin de la transacción, growing, commit o abort, y solo entonces shrinking.

Eso es lo que define esta variante y lo que garantiza serializabilidad fuerte: liberar los locks siempre después de los commits. Si se liberan antes del commit, alguien puede leer valores antes de tiempo. Está probado matemáticamente que así se garantiza serializabilidad. Y conviene ser precisos sobre el aporte de Gray, porque inventar el algoritmo no tiene tanto misterio: pedimos primero todos los locks y después los liberamos todos juntos. El aporte es haber demostrado que así se garantiza la serializabilidad que definimos. En el paper arman un grafo de precedencia, muestran que no tiene ciclos, y eso garantiza ejecuciones serializables.
Obtener los locks así, obviamente, puede producir deadlocks: si dos transacciones piden locks cruzados, se bloquea todo. Las formas de romperlos también se ven en Programación Concurrente, y seguramente ahí se explicó mejor, con las consecuencias de cada variante y qué pasa si se libera antes de los commits. No vamos a profundizar porque excede el tema de la clase.
Quedan dos cuestiones relevantes para nuestro tema. La primera es que el algoritmo es exactamente igual en un sistema distribuido: se piden primero los locks y se liberan después de los commits. La segunda, interesante cuando el sistema distribuido no es una base de datos, es dónde se guardan esos locks.
Hay muchas formas, pero típicamente —sobre todo en two-phase locking, donde hay que pedir muchos locks— se guardan en la misma base que tiene el dato. Volvamos al ejemplo del principio. Un sistema tenía una tabla de asientos, con el 2B que pedimos. Otro, el de tickets, tiene una tabla de tickets, con un ID cualquiera, el 233. El lock se suele guardar desparramado: la tabla de asientos tiene los locks de los asientos, generalmente en la misma tabla, o al menos conceptualmente. Va a haber un objeto que representa el lock y que típicamente registra quién lockeó: por ejemplo, el host 1. Del lado de los tickets pasa lo mismo. La granularidad es por registro: no se lockea la tabla entera sino la fila. En términos precisos: el lock vive en el servidor que contiene el dato.
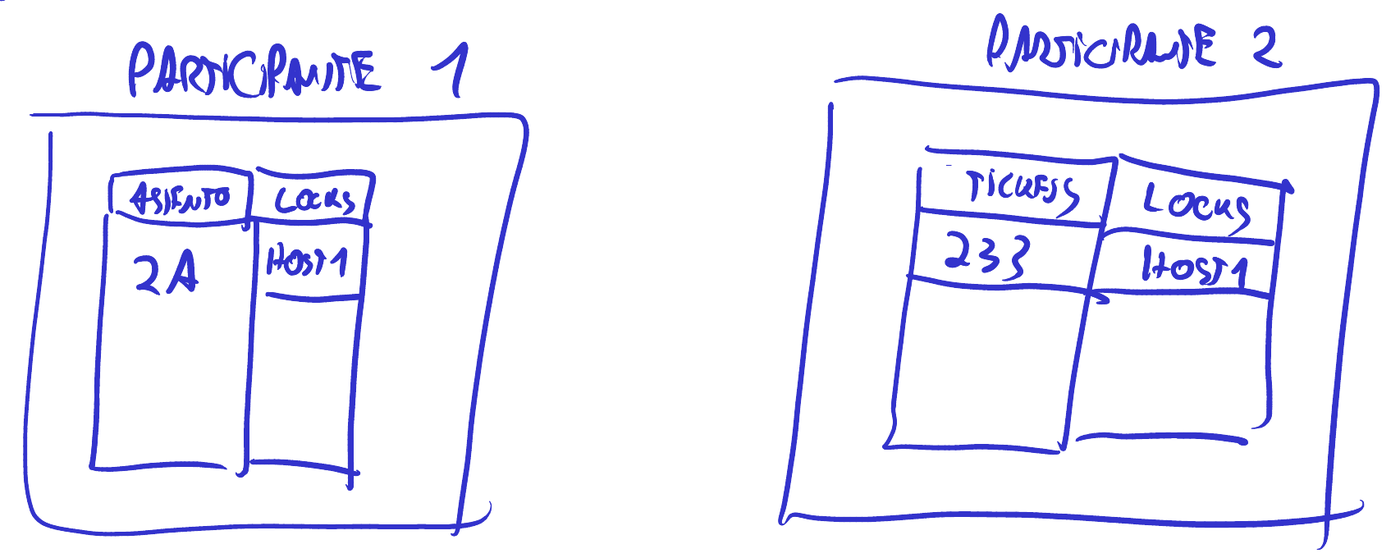
A veces se implementa manualmente y a veces el sistema lo tiene más escondido, pero es una forma bastante común de desparramar los locks. Es más raro ver un sistema centralizado para esto; lo común es que cada data node o storage node guarde sus propios locks. El nombre formal de cada uno es participante: participante uno, participante dos. Y en un sistema distribuido, igual que en una base común, eso garantiza serializabilidad. Spanner, que no es el sistema de hoy, va a usar exactamente eso.