2. Origen y modelo de programación de MapReduce
Con la cronología en la mano podemos preguntar: ¿qué resolvía MapReduce? Varios papers de esa era resuelven el problema de guardar datos; este resuelve el del cómputo. Dicho directamente: dividir un proceso de cómputo entre muchas CPUs.
Origen: transformación y agregación
El origen explica la forma que MapReduce terminó teniendo. Uno de sus dos creadores es Jeff Dean, hoy una figura muy visible y prácticamente una eminencia de la inteligencia artificial, pero que ya en esa época era importante.
Dean publicó hace poco, en febrero, un mensaje en el que contaba el origen de MapReduce: por qué se inventó, y coincide con lo que ya se sabía por otras fuentes. Lo que tenían que hacer, relata, era reconstruir el pipeline que indexaba la web. El contexto le da peso al problema: principios de los 2000, sin máquinas de gran potencia, y querían indexar la web entera con las máquinas que había.
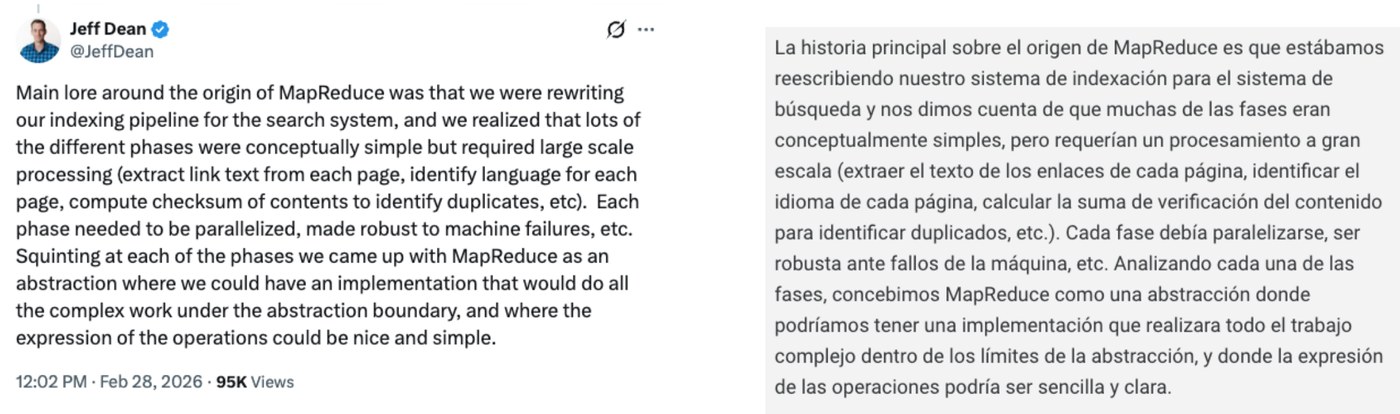
Y ahí viene la parte brillante, la que hoy damos por hecho: la separación entre transformar y agregar nos resulta natural porque la aprendimos ya hecha, pero a alguien se le tuvo que ocurrir. Se dieron cuenta de que muchos de esos algoritmos tenían la misma forma: matemáticamente, siempre una transformación y una agregación. Y los más complicados muchas veces se podían componer como una cadena de esas mismas operaciones: un MapReduce podía ser el input de otro, y con esa cadena se construían numerosos algoritmos. A las transformaciones las llamaron mappers, y a las agregaciones, reducers.
El paper es explícito sobre este origen y aporta los números que confirman ese encadenamiento. Su §7.1 cuenta que el sistema de indexación de la búsqueda web de producción de Google fue reescrito por completo para usar MapReduce, y que consiste en una secuencia de entre 5 y 10 operaciones de MapReduce encadenadas, en unas 3.800 líneas de C++. El caso que motivó el diseño no es solo el ejemplo de una charla: es el primer usuario del sistema.
La parte difícil era otra: cómo se distribuía. Reconocer que un algoritmo tiene la forma de una transformación seguida de una agregación no dice nada sobre cómo repartir ese trabajo entre muchas máquinas. Y aquí está la idea central: si los programadores hacían la parte fácil —entre comillas—, identificar esa estructura dentro de sus problemas, la difícil la podía hacer un sistema que la distribuyera automáticamente. Porque esa parte necesitaba expertos en sistemas distribuidos, y no tenían tantos. MapReduce era una forma de conectar a los dos grupos: unos escriben el mapper y el reducer, y el sistema, que hicieron los expertos una sola vez, se ocupa del resto.
Esa distribución es transparente, pero no tanto. Queda prácticamente escondida, sí, pero no es que uno tome cualquier algoritmo, lo lleve a MapReduce y funcione: quien lo haya usado tuvo que pensar en términos de mappers y reducers, adaptarse a lo que el sistema puede absorber. De ahí que la transparencia sea parcial.
El paper lo escribieron ese mismo Jeff Dean y Sanjay Ghemawat. Es una dupla conocida, y hay sobre los dos un artículo del New Yorker, “la amistad que hizo grande a Google”, ilustrado con una caricatura de ambos; está detrás de un paywall, aunque circula una versión archivada. No tiene nada que ver con la materia, pero es interesante como retrato de dos ingenieros trabajando en las eras iniciales de los sistemas distribuidos, en un modo muy diferente al de hoy.
El artículo es The Friendship That Made Google Huge, de James Somers, publicado en The New Yorker el 10 de diciembre de 2018. El paper de la clase es Jeffrey Dean y Sanjay Ghemawat, MapReduce: Simplified Data Processing on Large Clusters, OSDI 2004.
Modelo de programación y clave intermedia
El paper explica el modelo con detalle, así que alcanzan algunas ideas básicas. El objetivo es que el programador se dedique a pensar una función map y una función reduce, y que MapReduce maneje automáticamente la distribución.
El ejemplo del paper es el “hola mundo” de MapReduce: contar palabras en un corpus de documentos grandes.
La función map toma cada documento y, por cada ocurrencia de cada palabra, emite un par: la palabra y un uno. Después el reducer agrega todas las ocurrencias de esa palabra y suma esos unos. Escrito como en el paper:
map(String key, String value):
  // key: document name
  // value: document contents
  for each word w in value:
    EmitIntermediate(w, "1");

reduce(String key, Iterator values):
  // key: a word
  // values: a list of counts
  int result = 0;
  for each v in values:
    result += ParseInt(v);
  Emit(AsString(result));
Map recibe una clave y un valor —el nombre del documento y su contenido—, recorre las palabras y por cada una llama a EmitIntermediate con la palabra y el uno como texto. Reduce recibe una clave, que es una palabra, y un iterador sobre la lista de conteos; inicializa un acumulador en cero, convierte cada valor a entero, lo suma y emite el total. Ninguna de las dos habla de máquinas ni de redes.
Y ahí está el concepto más importante: ese primer valor del par que emite el mapper. Eso es la clave intermedia, y es lo que MapReduce va a usar para agrupar los pares entre sí.
En este ejemplo la entrada ya son archivos, y cada uno alimenta a un mapper: input 1, input 2 e input 3. Cada uno, conceptualmente (más adelante vemos cómo es en la realidad), entra en un mapper y emite una tira de pares.
Hagámoslo con letras, que es más corto. El primer input emite (a,1) y (b,1); en un caso real serían miles de pares. En el segundo estaba únicamente la b, así que emite (b,1) una vez. Y en el tercero vuelve a aparecer la a, la b no, y aparece la c: emite (a,1) y (c,1).
Lo que tiene que hacer el reducer —y esta es la parte más interesante— es reunir todas las a de todos los mappers y enviárselas a una función reduce; agrupar todas las b y enviarlas a otra; y las c a una tercera, aunque la c aparezca una sola vez. Resultados: a vale 2, b vale 2 y c vale 1.
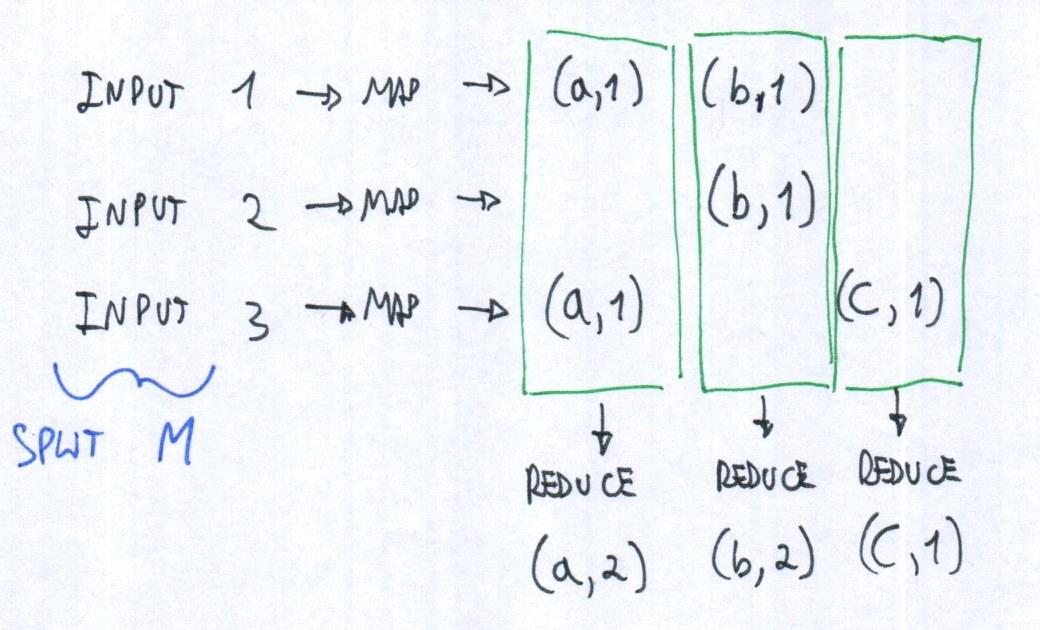
Ese agrupamiento se hace por la clave intermedia, que es siempre el primer valor del par ordenado que se emite.
De ahí se infiere algo sobre la otra clave, la de entrada, que las implementaciones que hayamos usado seguramente simplifican: el mapper recibe una clave y un valor, pero esa clave de entrada no se usa para mucho. En el conteo de palabras es el nombre del documento, y el cálculo no la mira jamás.
El paper además pone los tipos, donde cada letra representa un tipo:
map    (k1, v1)        → list(k2, v2)
reduce (k2, list(v2))  → list(v2)
Esas dos líneas dicen que map recibe una clave y un valor de tipos k1 y v1, y emite una lista de claves y valores de tipos k2 y v2. Y que esos k2 y v2 son los tipos que recibe el reducer: la misma clave y una lista ya agrupada de los valores. La salida de reduce es a su vez una lista de valores de ese mismo tipo v2.
El paper agrega en §2.2 por qué la firma de reduce termina en
list(v2)y no en un tercer par de tipos: las claves y los valores de entrada vienen de un dominio distinto que los de salida, pero los intermedios son del mismo dominio que los de salida. De ahí también sale la respuesta a algo que choca al leer el código:EmitIntermediate(w, "1")emite el uno como cadena, y por eso reduce haceParseInt(v)yAsString(result). No es un descuido: la implementación en C++ pasa cadenas hacia y desde las funciones del usuario, y deja la conversión de tipos de ese lado.