1. Transacciones distribuidas y propiedades ACID
En esta sección
Ejemplo: reserva de vuelos con dos servicios
Agrupar varias operaciones para que se comporten como una sola es mucho más común de lo que uno piensa. Pasa incluso cuando no estamos construyendo un sistema distribuido: la gente implementa transacciones distribuidas de manera implícita todo el tiempo, sin darse cuenta. La intuición ya la tenemos —quien cursó bases de datos vio transacciones, y todos cursamos Programación Concurrente, así que varias cosas van a sonar conocidas—: tomar un conjunto de operaciones y tratarlo como una unidad. El objetivo es el mismo de las transacciones de siempre, con las mismas propiedades. Lo que cambia es que ahora las operaciones ocurren en sistemas distintos, y entre hoy y la clase que viene vamos a recorrer distintas maneras de implementarlas en ese escenario.
El ejemplo que mejor lo muestra es un sistema distribuido que a primera vista no lo parece. Imaginemos un sistema de reserva de vuelos —de tickets, más precisamente—. Está el usuario, el frontend con el que habla, y detrás una base. Para complicar un poco el cuadro, supongamos que en lugar de una sola base tenemos dos sistemas separados: uno que reserva los asientos y otro que emite los tickets. En la vida real cada uno tiene a su vez varios subsistemas comunicándose entre sí, pero con dos alcanza para ver el problema. Llamémoslos asientos y tickets.
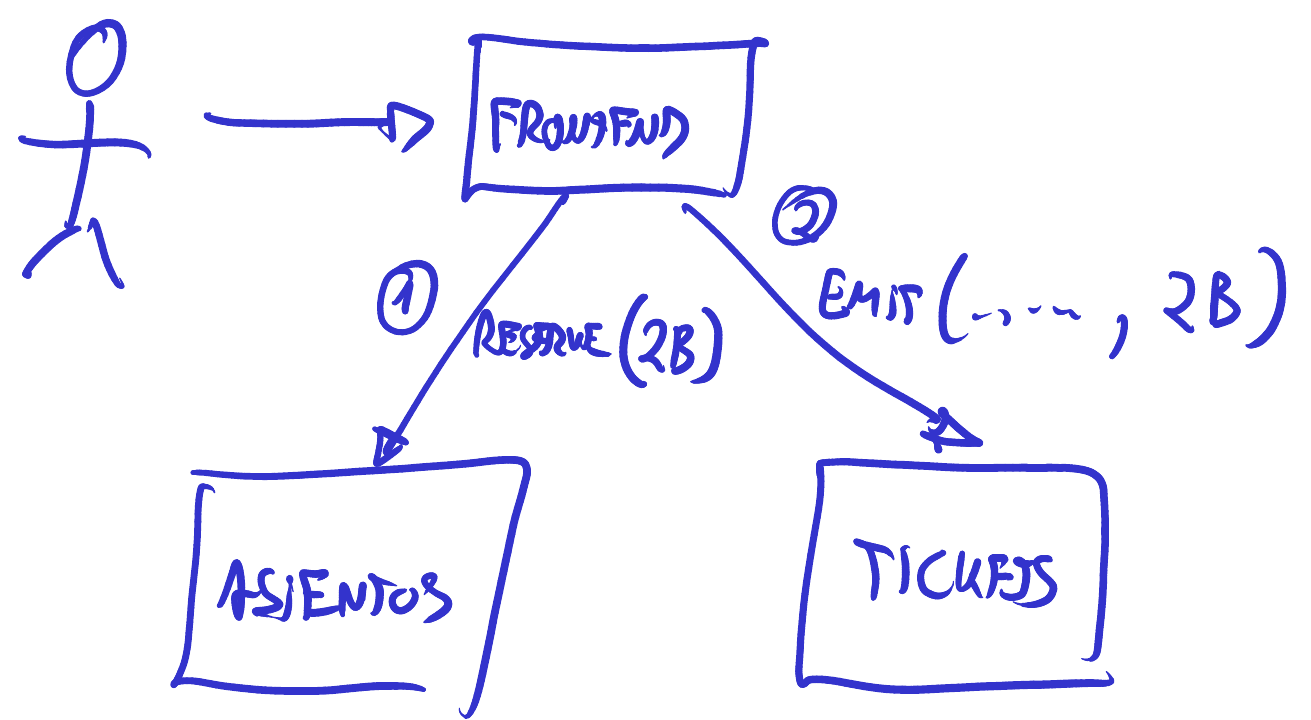
Si el frontend lo escribimos nosotros, típicamente vamos a llamar a reserve por un lado y a emit por el otro: reserve del asiento 2B, y emit con los datos del pasajero, entre los cuales irá también el asiento reservado. Y lo vamos a hacer en orden: primero uno y después el otro. Si al reservar el 2B hay un problema de concurrencia porque alguien se nos adelantó, se cancela todo y hay que elegir otro asiento. Solo cuando el 2B quedó reservado se emite el ticket.
Esto, aunque no lo parezca, es una transacción. Si fueran dos tablas de una base relacional, escribiríamos un begin, ejecutaríamos las dos operaciones adentro y alguien ya habría resuelto el problema por nosotros. Con dos microservicios —para ponerle un nombre moderno— nadie lo resuelve, y tenemos problemas. Lo que acabamos de describir es la implementación naïve, la obvia, la que casi todos hacen la primera vez que construye un sistema de este tipo.
Un diagrama de tiempo separa lo que puede funcionar bien de lo que puede funcionar mal. Tenemos tres líneas de vida: frontend, asientos y tickets. El usuario le manda el pedido al frontend, el frontend le manda reserve a asientos, asientos responde OK, y solo con ese OK el frontend le manda el emit a tickets, que también responde OK. Ese es el camino feliz. ¿Qué puede salir mal?
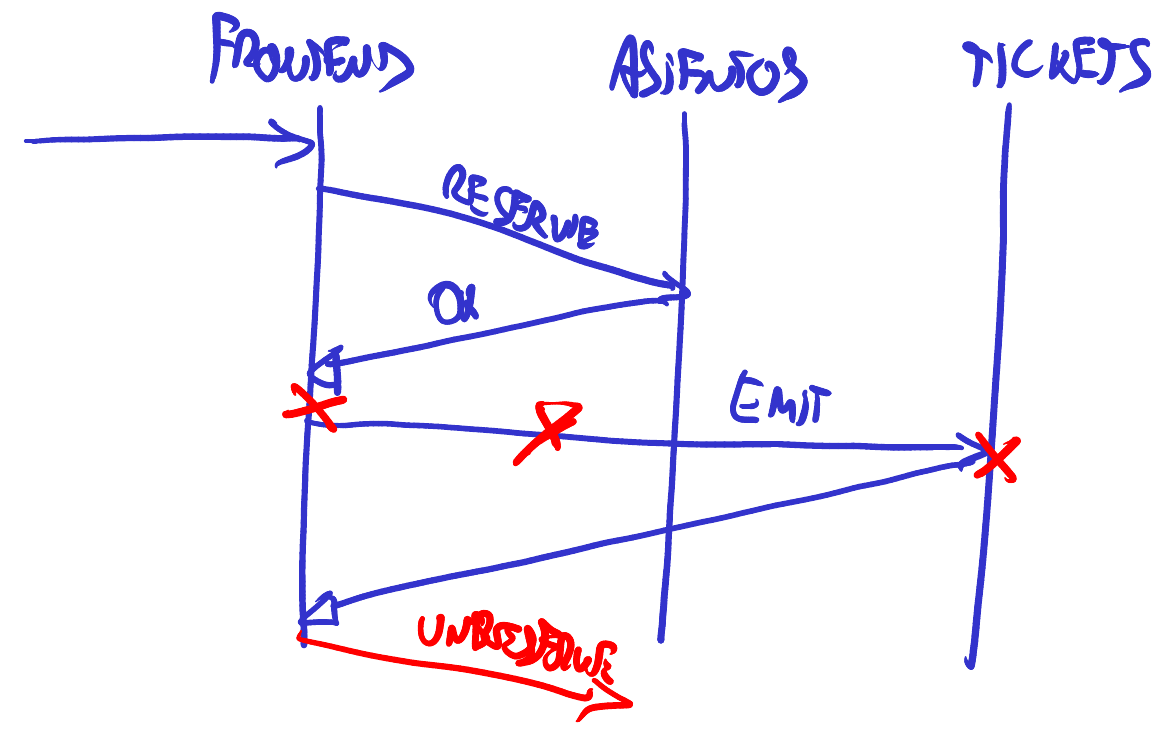
Si la falla ocurre antes del reserve no es terrible: no quedó nada persistido en ningún lugar. El primer caso interesante es otro. Asientos dice que el asiento está disponible y queda reservado, la respuesta vuelve al frontend… y el frontend entero muere. No es frecuente, pero puede pasar: supongamos un out of memory porque hay muchísimos requests concurrentes, con muchos usuarios intentando reservar asientos y llamando al sistema de asientos. Ese problema es serio, aunque no catastrófico: se puede detectar y alguien puede liberar manualmente esos asientos. Pero si no se corrige automáticamente, es un problema grave: un vuelo despega con un asiento vacío simplemente porque nuestro sistema está mal diseñado.
El segundo punto de falla está en el emit, y ahí vuelven cosas que ya vimos en otras clases. El pedido llega a tickets, el ticket se emite, pero la respuesta no nos llega. Como no hubo respuesta, podemos decidir revertir la reserva… pero el ticket ya está emitido. El tercer punto de falla es el propio sistema de tickets: si falla él, no sabemos si alcanzó a guardar el ticket o no. Entonces reintentamos, y de ahí se abre otra cadena de preguntas.
A esta altura deberíamos estar pensando que ninguno de estos problemas es tan terrible, que venimos pensando soluciones para este tipo de situaciones toda la materia. Hay dos cosas para decir. La primera es que sí, con lo que ya sabemos de sistemas distribuidos podríamos deducir soluciones; hoy lo vamos a estudiar de manera organizada, bajo el tópico de las transacciones distribuidas. Y esto es una transacción justamente porque queremos que ocurran ambas operaciones o ninguna: all or nothing.
La segunda es que este ejemplo es quizás el más relevante de toda la clase, porque es el error que se comete una y otra vez. Cuando hay que llamar a dos sistemas, la reacción habitual es ignorar el problema: se asume que los dos van a funcionar y ni se piensan los casos de falla. A veces se piensa un poco y aparece la solución de la excepción: si funciona el primero y falla el segundo, un catch revierte el primero. Recorrámoslo. El asiento se reserva, el segundo llamado falla y tenemos la certeza de que falló. En el catch llamamos al sistema de asientos y le decimos unreserve —una operación que estamos inventando en el momento, porque no existía hasta que la necesitamos—. El problema es que si falla el mecanismo de reversión, seguimos exactamente en el mismo lugar: apenas movimos el punto donde se rompe. Por suerte cómo mitigar esto ya lo pensó mucha gente, pero en la vida real nos lo vamos a encontrar con frecuencia, incluso a niveles más abstractos.
Escritura en la base y aviso por una cola
La otra situación típica aparece en sistemas por todos lados: escribimos en la base de datos y después mandamos un mensaje por una cola para avisarle a otro sistema que escribimos. Las variantes fallan de tres maneras. Si escribimos en la base pero falla la cola, el otro nunca se enteró. Si invertimos el orden, puede fallar la base: mandamos un mensaje, alguien lo recibió, y no hay nada escrito. Y la tercera variante es peor, porque no requiere que falle nada: mandamos el mensaje, la escritura se demora un poco, el receptor va a la base a buscar lo que supuestamente escribimos, no encuentra nada, aborta lo que tenía que hacer, y solo después escribimos. Nadie falló y, aun así, el resultado quedó mal.
Las transacciones entran en esta clase porque el problema es mucho más común de lo que uno pensaría. No hay que ser ingeniero de Amazon o de Google para encontrárselo, y resolverlo bien es mucho más difícil de lo que uno imagina. Nos lo vamos a encontrar seguro, aunque no hagamos sistemas distribuidos en la vida. Conviene ser el ingeniero que, en el equipo, pregunta qué pasa si falla la cola de mensajes, aunque traer ese caso borde no siempre sea bienvenido.
No siempre hace falta un sistema de transacciones complicadísimo para resolver esas mini transacciones de escribir en una base y mandar por una cola sin perder nada; en la clase de message queues y message oriented middleware lo vamos a repensar con otras herramientas. Pero si lo queremos resolver formalmente, como transacciones distribuidas, primero necesitamos una introducción al tema, y después podemos mirar cómo lo resolvió DynamoDB. En DynamoDB uno escribe items individuales —ni siquiera les llaman filas—, y nada más. El pedido de escribir muchos items a la vez estuvo desde siempre, y eventualmente lo implementaron; eso también lo vamos a estudiar. Pero vamos primero por lo más abstracto, las transacciones en general, que para quien vio bases de datos va a ser casi lo mismo.
Este problema ya apareció en la Práctica 1 con su nombre más conocido, dual writes: un contexto de ejecución sin estado durable que escribe en dos sistemas que no comparten una transacción. Ahí se resolvió sin transacciones distribuidas, con una variante del outbox pattern: un consumidor que lee los cambios desde el WAL de la base. Con ese mismo nombre lo tratan Martin Kleppmann y Chris Riccomini en Designing Data-Intensive Applications (2.ª ed., O’Reilly, 2026), cap. 12, “Keeping Systems in Sync”, donde señalan que lograr que las dos escrituras ocurran o fallen juntas es un caso del problema de atomic commit, el que resuelve el two-phase commit.
Propiedades ACID
¿Qué queremos lograr con una transacción? Las propiedades son las cuatro de siempre, ACID, y de ellas nos interesan principalmente dos.
La primera es la atomicidad: todo o nada. La transacción se ejecuta completa o no se ejecuta nada. Mando un mensaje por la cola y escribo en la base: las dos cosas o ninguna. Y —esto es lo importante— también cuando hay fallas. Parcialmente ya vimos esta idea con el nombre de atomic write: que el write parezca una única operación aunque implique varias, que es exactamente el caso acá. Una diferencia, porque es fácil confundirlas: esto no es replicación. No ejecutamos la misma operación en varias réplicas, sino operaciones distintas en sistemas distintos, y por eso RAFT no nos sirve.
La segunda es la consistencia, y no le vamos a dar mucha atención. Una pregunta del principio de la clase toca justo este punto: la linealizabilidad es sobre consistencia, y también lo son la consistencia eventual y la débil. Sin embargo, esa consistencia no es esta. Esta es la acepción de la gente de bases de datos, y se refiere a las invariantes que tienen que valer adentro de la base: por ejemplo, si un campo es clave única, una transacción no puede generar un duplicado. No es la consistencia de la que veníamos hablando, ni la del teorema CAP. La dejamos de lado, sin relación con lo anterior.
La tercera es el aislamiento —isolation—, y esta sí es la otra importante. Vamos a hablar de ella toda la clase, y en la práctica se estudia bajo el nombre de control de concurrencia: locks y mecanismos afines.
La cuarta es la durabilidad, de la que tampoco vamos a hablar mucho, porque venimos hablando de durabilidad desde el principio de los tiempos. En una base de datos se garantiza escribiendo en el disco; en un sistema distribuido, en muchos discos. De ahí viene la replicación. No trae nada nuevo con las transacciones.
Las que sí traen cosas nuevas son la atomicidad y el aislamiento. Sobre todo la atomicidad, porque para conseguirla vamos a ver el gran algoritmo de todo esto —que ya vimos un poco—: el two-phase commit. La clase de hoy es, en buena medida, sobre el two-phase commit. Pero primero arrancamos por el control de concurrencia.
Serializabilidad
Hay una palabra parecida a linealizabilidad pero diferente, más de la gente de bases de datos: serializabilidad. Es la propiedad que nos interesa para que las operaciones estén aisladas entre sí. Conviene escribir la definición entera: una ejecución de transacciones es serializable si existe un orden serial —una transacción a la vez— que da el mismo resultado. Esa última parte es la clave.
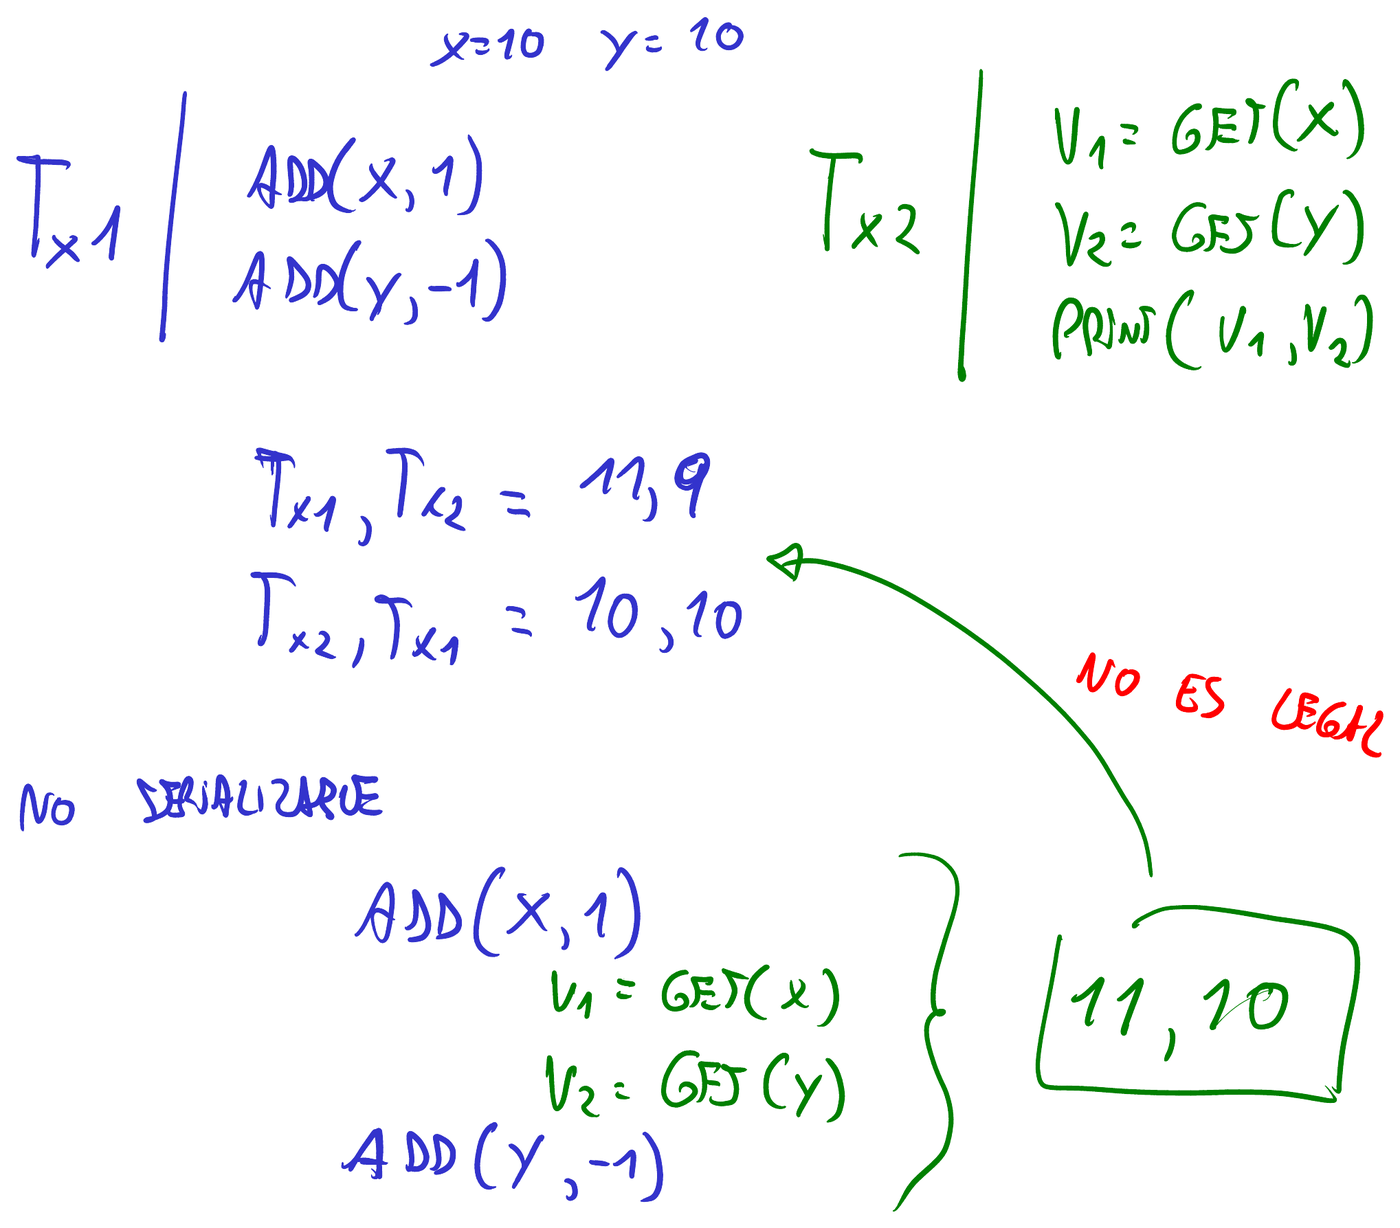
Veámoslo con un ejemplo, que es un repaso de bases de datos. La base arranca con x = 10 e y = 10. La primera transacción, Tx1, hace dos sumas: ADD(x, 1) y ADD(y, −1). La segunda, Tx2, lee: V1 = GET(x), V2 = GET(y) y PRINT(V1, V2); el print está solo para mostrar el resultado.
Lo que importa es que cada transacción se ejecute toda junta, aunque en la base las operaciones seguramente se intercalen. El resultado neto tiene que ser como si se hubiera ejecutado primero una y después la otra; de ahí el nombre. Los dos órdenes posibles, si son serializables, son Tx1 y después Tx2, o Tx2 y después Tx1.
Si ejecutamos Tx1 primero obtenemos 11 y 9: primero se modificó y después se imprimió. Al revés, primero imprimimos y después modificamos, y da 10 y 10. Estos dos, y solo estos dos, son los resultados posibles si la base nos garantiza serializabilidad.
¿Qué sería una ejecución no serializable? Una donde las operaciones se intercalan de formas raras. Supongamos que se ejecuta ADD(x, 1), después V1 = GET(x), después V2 = GET(y) y al final ADD(y, −1). Obtuvimos la x después de sumarle, 11, y la y antes de restarle, 10. Ese resultado, 11 y 10, no está entre los dos que teníamos. No es legal, precisamente porque se mezclaron las operaciones: esa ejecución no es serializable.
¿Por qué existe el concepto? Pasa algo parecido a la linealizabilidad: un concepto fácil cuya definición es difícil, y que, bien pensado, resulta evidente. La serializabilidad es evidente porque describe cómo querríamos que fueran las cosas en nuestra cabeza. Cuando escribimos un bloque de código que ejecuta varias operaciones juntas contra una base, nos imaginamos que mientras eso corre ninguna otra operación va a interferir modificando los datos. Estamos pensando, sin decirlo, en un orden serial.
Después, las bases reales tienen niveles de aislamiento más débiles. Pueden permitir, por ejemplo, leer un valor de una transacción que después aborta, entre otras anomalías en las que no nos vamos a meter. La que dimos es la definición más dura de isolation: que sea como si las transacciones vinieran una a la vez, aunque la base las optimice y reordene por dentro. Hay paralelismo, y sin embargo el resultado tiene que ser el de una ejecución sin él.