4. Zookeeper: consenso como servicio
En esta sección
Consenso como biblioteca o como servicio
Ahora sí pasamos a Zookeeper. Todo lo anterior resulta pertinente porque se trata de un sistema muy similar a lo que estamos construyendo, y a lo que vamos a construir en el TP3, y porque no emplea consistencia fuerte: deliberadamente no es linealizable, para obtener más performance.
Cuando uno se dedica a implementar Raft advierte algo que se refleja en las preguntas que surgen: es difícil. Era difícil implementar Paxos, es difícil implementar Raft, y los algoritmos de consenso siempre van a serlo. De allí surge una pregunta puramente de ingeniería: ¿cómo hacemos para que una empresa, o un sistema open source, pueda usar un algoritmo de consenso sin implementarlo desde cero?
La primera opción es incorporarlo a una biblioteca: uno la descarga, la configura y la integra a su sistema. Eso es lo que vamos a hacer en el TP3: lo desarrollado en el TP2 lo vamos a incorporar como una biblioteca, le vamos a agregar encima una key-value store —nada demasiado complejo— y así vamos a disponer de Raft.
La otra propuesta, la que adoptaron varias empresas, es encapsular el algoritmo como un servicio independiente, cuyo único propósito es ofrecer distintas primitivas que ellos denominan de coordinación. Un sistema de coordinación, entonces. Y resulta más claro mostrar ejemplos de qué significa eso que explicarlo en abstracto.
El contraste se aprecia mejor en un diagrama. En lugar de la aplicación con Raft por debajo, tenemos la aplicación sola comunicándose por la red con un servicio: una caja negra, el sistema de coordinación, que va a ser Zookeeper. Se comunica con RPC, con REST o con el protocolo que sea, y cuál sea no introduce diferencias, porque lo que define al servicio es que del otro lado de la red hay una interfaz bien definida, una API. Es comparable a un servidor web: algo separado de la aplicación, con la red en el medio. Nunca accedemos al algoritmo de consenso directamente, sino a través de esa interfaz.
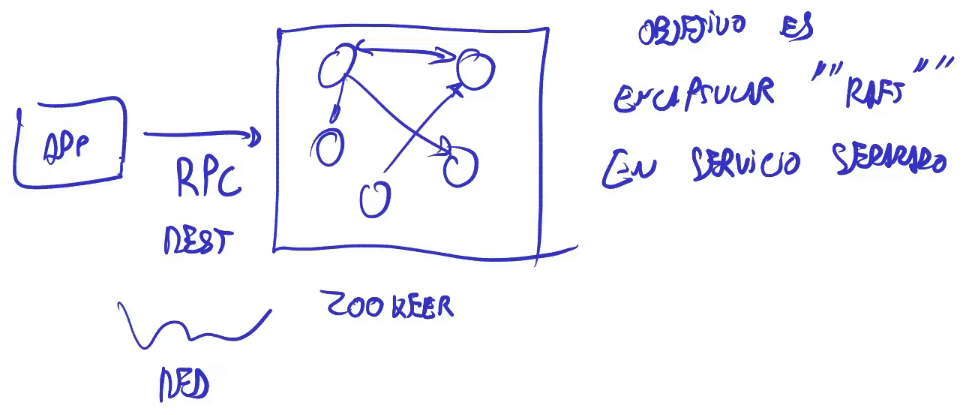
El diagrama puede inducir a confusión en un punto: esa caja representa un sistema, no una máquina. Es la que va a contener los cinco nodos comunicándose entre sí.
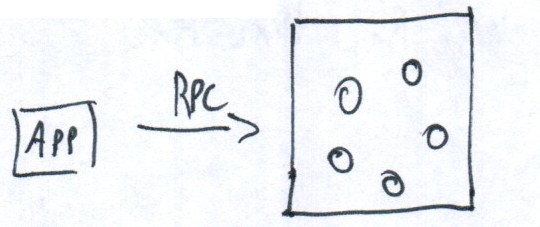
La consecuencia práctica es considerable: toda la parte difícil del trabajo ya la resolvieron los autores de Zookeeper. Si el servicio falla, uno recurre a quienes lo mantienen. Como usuarios lo tenemos encapsulado, del mismo modo que si usáramos cualquier otro sistema: el objetivo es ese. En el diagrama conviene anotar “Raft” entre comillas, porque no se trata de Raft; de hecho, Raft apareció después que Zookeeper. Lo que hay allí es un algoritmo de consenso integrado en un servicio separado.
Todo esto constituye un problema de ingeniería que varias empresas enfrentaron al mismo tiempo, cada una por su cuenta. Google llegó a esta solución —lo señala el paper— porque necesitaba un sistema de locks distribuido, y comprobó que, para que fuera tolerante a fallas, se encontraba con todos los problemas que venimos discutiendo desde hace tres semanas. Desarrollaron entonces un sistema que los encapsulaba: Chubby. El paper está disponible, no vamos a leerlo, pero resulta interesante. Internamente usa Paxos, el algoritmo que no vimos, está especializado en locks, y contiene una idea que Zookeeper adoptó: no es una base de datos key-value ni relacional, sino una estructura jerárquica que se presenta como un file system, donde se almacenan las claves y los valores.
Amazon desarrolló su propio sistema, pero no lo divulgó: es interno, se llama ALF y no es de acceso público. También usaba Paxos, para exactamente el mismo problema. No hay nada publicado al respecto, lo cual tiene su propio interés.
Y Yahoo, que es el caso que nos ocupa hoy, desarrolló Zookeeper. Internamente usa ZAB, el algoritmo de consenso creado por ellos mismos. Lo notable es que resulta similar a Raft, aun habiendo aparecido antes: para el resto de la clase vamos a asumirlo prácticamente como Raft, porque funcionan de manera muy parecida y ofrecen las mismas garantías. Todo lo que sabemos de Raft nos resulta aplicable aquí.
Servicios de coordinación
Lo que todos estos sistemas pretendían resolver con un servicio de coordinación se expone mejor con ejemplos que en abstracto.
Uno de los problemas más frecuentes son los locks distribuidos, y hoy vamos a ver un ejemplo con Zookeeper. El concepto de lock no es nuevo: apareció en varias materias anteriores, sobre todo en concurrencia, y allí resulta sencillo porque hay memoria compartida. Pero suele surgir la necesidad de construirlos también en un sistema distribuido, y allí es muchísimo más difícil. Por eso pretendían tomar todo el problema de la persistencia de esos locks y ocultarlo dentro de un sistema como Zookeeper.
El segundo ejemplo es la elección de líder. Parece sencilla, pero a esta altura, habiendo estado implementando Raft, ya sabemos que implementarla correctamente es una tarea considerablemente compleja. Lo que pretendían era delegar esa maquinaria a un sistema que implemente Raft y utilizarlo desde afuera. Eso también lo vamos a ver hoy, y constituye una extensión de los locks.
El tercero es la membresía de grupo: un repositorio donde se registra qué elementos integran un grupo. Un caso particular es un cluster de máquinas y la pregunta de cuáles son sus componentes. Aquí conviene conectar con algo ya visto: Dynamo, o el consistent hashing, donde se arma un anillo y los elementos se distribuyen alrededor. Lo que probablemente no se mencionó es que, para que eso funcione, todas las máquinas deben saber dónde están todas, que son cinco, y enterarse si alguna falla. Eso suele denominarse la configuración del sistema: qué máquinas hay y qué se conecta con qué. Y puede delegarse a un sistema como Zookeeper.
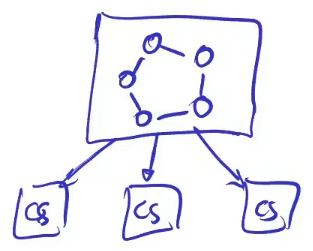
Para pasar a ejemplos más concretos, conviene volver al Google File System. Allí teníamos varios chunkservers y el master, que contenía toda la información general del sistema. El problema era que el master constituía el punto débil: si fallaba, fallaba todo el sistema. Eso puede evolucionar: que no sea una máquina única, un único punto de falla, sino un sistema distribuido reducido con consenso en su interior. Ese sistema podría ser Zookeeper, o Chubby, o el ALF de Amazon, y de ese modo se incorpora tolerancia a fallas. Aparentemente es algo de ese estilo lo que hicieron con la versión siguiente del GFS, denominada Colossus.
De hecho, estos sistemas de coordinación están presentes en todas partes y es inevitable que aparezcan; lo deseable es que permanezcan muy ocultos, porque constituyen la parte más difícil. Es sencillo, por ejemplo, resolver una elección de líder con una base de datos: el primero que escribe su nombre en una tabla de DynamoDB resulta electo. Pero si uno indaga, descubre que dentro de DynamoDB esa tabla está replicada en tres lugares que se coordinan con un algoritmo también similar a Raft. Siempre está presente, aunque no se vea: difícilmente pueda construirse un sistema tolerante a fallas que no incorpore algo de esto en algún lugar.
La clave del diseño consiste en organizarlo de manera tal que no todos los participantes deban ejecutar Raft con todos los demás, sino que esa información pueda delegarse en una base de datos reducida y aislada. En el TP3 la configuración del sistema también se va a almacenar en Zookeeper: no vamos a implementarlo, sino a utilizarlo para guardar estos datos, y eso va a resultar tolerante a fallas. Y se aplica también a MapReduce, que presentaba el mismo problema del único punto de falla en la capa superior.
Arquitectura, API y objetivo de diseño
Con eso ya sabemos para qué sirve. Su funcionamiento presenta poca novedad —se irá completando a medida que avancemos—: en principio, Zookeeper también opera con un sistema de mayorías y de quórum.
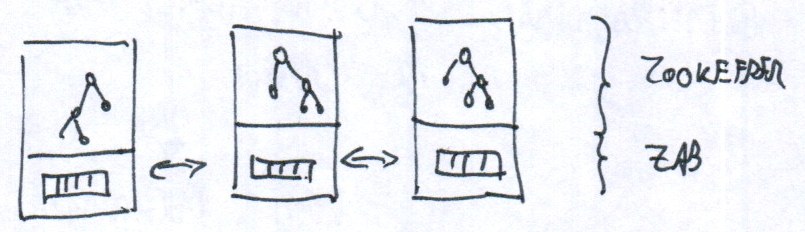
Dibujemos tres máquinas, y asignémosle a cada una dos mitades. La superior podemos denominarla Zookeeper propiamente dicho, y la inferior implementa ZAB. Arriba la estructura es un storage un tanto oculto: uno imaginaría una gran base de datos, pero lo que hay es una base de datos pequeña con estructura de file system. Abajo, el elemento principal de ZAB es un log. Esos logs se comunican entre sí y las operaciones se aplican en la capa superior —el file system de cada nodo— del mismo modo que en Raft. Es la estructura que vamos a construir en el TP2 y el TP3, y cada réplica contiene exactamente lo mismo.
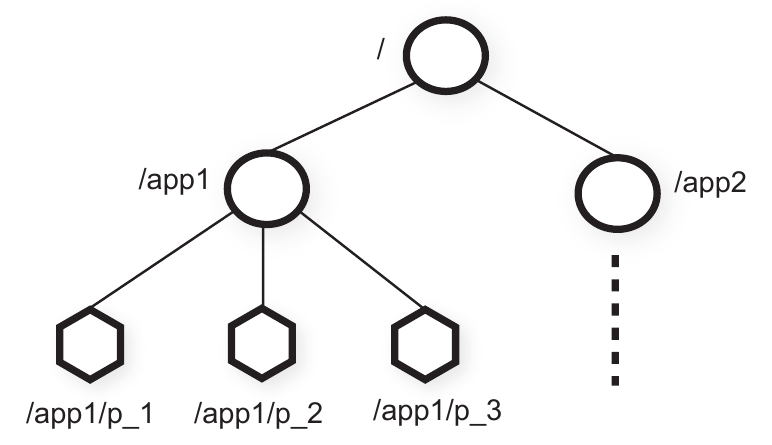
El paper expresa exactamente eso: la figura ilustra la estructura jerárquica de los nodos, que se asemejan mucho a un file system. Cada nodo puede contener un dato además del nombre, y los paths se forman igual que en un file system. Y hay un punto importante: eso no introduce ninguna diferencia. Es simplemente la manera en que está implementado ese storage de la capa superior, y la optimización de cómo hacerlo eficiente constituye otro tema que no vamos a abordar.
Con el diagrama presente podemos dar una primera aproximación a la API: qué expone esa caja negra. La vamos a examinar en detalle más adelante, de modo que no es necesario recorrerla operación por operación. Hay una primitiva para crear un nodo, a la que se le pasa el path, la data y algunas flags que después van a resultar relevantes. Hay una para borrar, una para verificar que un nodo existe, otra para obtener la data y otra para listar los hijos. Y hay sync, que si queda tiempo la veremos y no resulta tan relevante: sirve para sincronizar la consistencia eventual que atraviesa todo el sistema.
Listar los hijos merece un comentario aparte. Es la única específicamente vinculada al hecho de que se trate de un file system: si no lo fuera, no existiría el concepto de hijos. Y los children van a resultar útiles para implementar, por ejemplo, los locks.
Lo notable de la API es su simplicidad, su escasa especificidad y, sobre todo, lo que no incluye. En ningún lugar aparece una operación “crear lock”. Vamos a poder implementar locks, sí, pero con estas primitivas. No hay elección de líder, no hay membresía de grupo, no hay nada de eso: disponemos de esas primitivas y nada más.
Y llegamos a un punto interesante, una propiedad del diseño planteada como objetivo no funcional: Zookeeper es un sistema dominado por lecturas. El paper señala que eso depende de la aplicación: como mínimo, el doble de lecturas que escrituras; como máximo, unas cien veces más. En ese extremo las lecturas constituyen el 99 % de las operaciones, con lo cual el sistema debe estar muy optimizado para leer y no tanto para escribir.
¿Y cómo se obtiene tanta performance? Relajando la linealizabilidad que ofrecía Raft: todo lo que explicamos anteriormente, que el líder debía verificar con los demás que continuaba siéndolo para devolver una lectura confiable. Eso se descarta. Con la linealizabilidad activa, los cinco nodos de la caja eran cinco copias de un mismo embudo; sin ella, los cinco pueden responder lecturas en paralelo.
Los dos movimientos son estos. Conceptualmente, Zookeeper descarta la linealizabilidad —que debe traducirse siempre como consistencia fuerte—. Y en la práctica, eso se implementa permitiendo leer de los followers. Vamos a comprobar que puede lograrse todo lo que necesitamos sin consistencia fuerte, incluso aquellas operaciones que parecerían requerirla, como elegir un líder o tomar un lock.